¿Qué es el aprendizaje federado y qué ventajas tiene? Guía práctica para empresas

El aprendizaje federado permite entrenar modelos de inteligencia artificial sin centralizar los datos. Este artículo explica con precisión cómo funciona, qué ventajas reales ofrece y qué limitaciones hay que considerar antes de desplegarlo en un proyecto empresarial. Se presentan pasos concretos, métricas útiles y un ejemplo práctico aplicado al sector salud.
¿Qué es el aprendizaje federado?
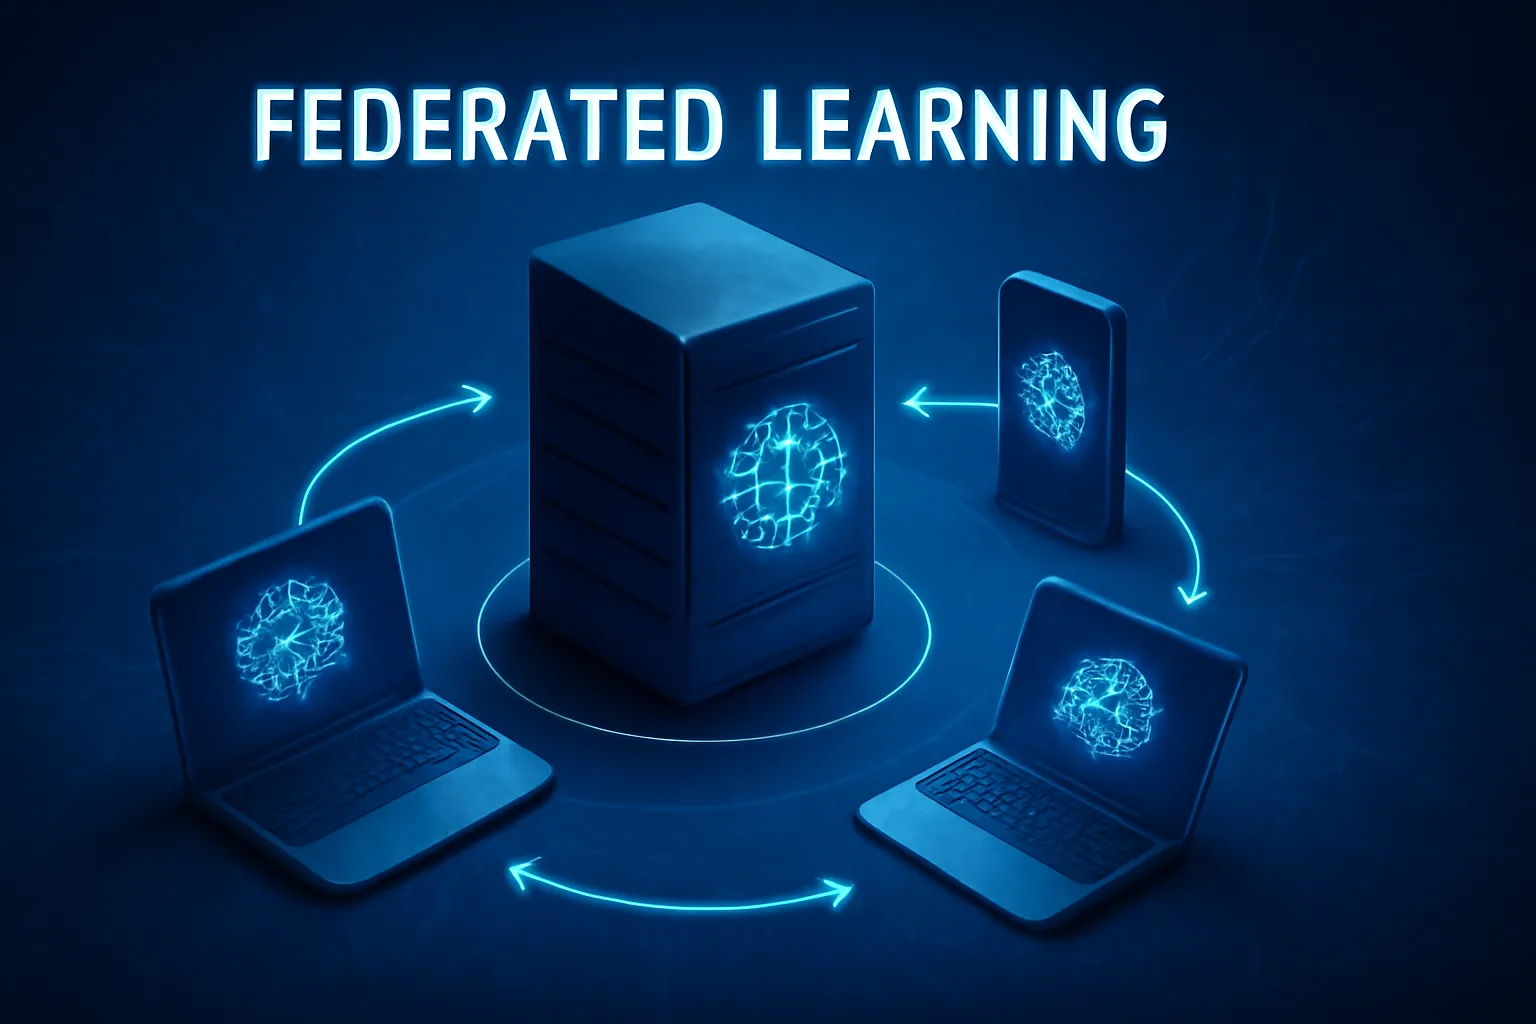
El aprendizaje federado es una arquitectura de entrenamiento distribuido en la que múltiples nodos —dispositivos móviles, servidores locales o sucursales— colaboran para ajustar un modelo común. Cada nodo entrena localmente con sus propios datos y solo comparte actualizaciones del modelo (por ejemplo, gradientes o parámetros) con un agregador central. De ese modo, los datos sensibles nunca abandonan su origen, lo que reduce la exposición y facilita el cumplimiento de requisitos regulatorios.
Cómo funciona: flujo y componentes
En su forma más habitual intervienen tres elementos: clientes, servidor de orquestación y el proceso de agregación. El flujo simplificado es:
1) El servidor distribuye el modelo inicial. 2) Cada cliente realiza varias iteraciones de entrenamiento local sobre sus datos. 3) Los clientes envían las actualizaciones al servidor. 4) El servidor agrega las actualizaciones y actualiza el modelo global. 5) Se repite hasta convergencia.
Proceso técnico
El entrenamiento local suele incluir mini-batches, optimizadores y técnicas estándar de ML. Para minimizar la comunicación, se emplean estrategias como compresión de gradientes, cuantización o entrenamiento por rondas en lugar de sincronización por lote.
Comunicación y agregación
La agregación más común es FedAvg, donde el servidor calcula una media ponderada de parámetros por tamaño de muestra. Sin embargo, en escenarios con clientes heterogéneos se utilizan variantes robustas que liman sesgos y mitigan efectos de clientes defectuosos.
Ventajas principales
El aprendizaje federado aporta beneficios prácticos más allá de la sola privacidad. A continuación se detallan las ventajas clave:
- Privacidad y cumplimiento: al mantener los datos en el lugar de origen, facilita el cumplimiento de normativas como leyes de protección de datos o requisitos sectoriales (sanidad, banca).
- Personalización: permite adaptar el modelo global a patrones locales mediante ajustes finos o modelos personalizados por cliente.
- Reducción de costes de transferencia: al enviar solo parámetros o gradientes, disminuye el volumen de transferencia respecto a la centralización completa de datos.
- Escalabilidad horizontal: se aprovecha la capacidad de cómputo distribuida en endpoints o centros locales.
- Resiliencia a fallos de red: los nodos pueden entrenar de forma intermitente y sincronizarse cuando la conexión esté disponible, lo que mejora la robustez operativa.
Limitaciones y riesgos
Ninguna solución es universal. El aprendizaje federado introduce complejidades operativas y riesgos que deben gestionarse:
Desafío de convergencia: la heterogeneidad de datos entre clientes puede ralentizar o impedir la convergencia del modelo global. En datasets no IID (no idénticamente distribuidos) son necesarias técnicas de regularización y ajuste del ritmo de aprendizaje.
Costo de comunicación y cómputo: aunque se evitan transferencias masivas de datos, el intercambio frecuente de parámetros y la necesidad de cómputo en los bordes puede imponer requisitos de hardware y ancho de banda.
Seguridad y ataques: ataques por envenenamiento de modelos (model poisoning) y ataques por inferencia pueden comprometer resultados o extraer información. Es necesario combinar federado con técnicas de defensa: agregación robusta, verificación de clientes y pruebas de integridad.
Auditoría y trazabilidad: auditar el proceso de entrenamiento distribuido requiere registro y trazabilidad de rondas, clientes participantes y versiones de modelo.
Ejemplo práctico: proyecto federado en salud
Un consorcio de hospitales busca entrenar un modelo para detección temprana de cardiopatías a partir de electrocardiogramas (ECG) sin compartir historiales clínicos. Diseño de proyecto:
1. Preparación de datos: cada centro estandariza su pipeline de preprocesado (normalización, filtrado), etiqueta los registros y define métricas comunes (AUC, sensibilidad, especificidad).
2. Arquitectura: se elige un modelo CNN ligero que pueda ejecutarse en servidores locales. El servidor central orquesta rondas con FedAvg y un número de clientes por ronda balanceado para evitar sesgos por tamaño de hospital.
3. Privacidad y seguridad: se implementa cifrado en tránsito y técnicas de diferencial privacy para limitar la información extraída de las actualizaciones. Además, se aplica un filtro de outliers en las actualizaciones para detectar posibles fallos o ataques.
4. Métricas y validación: cada ronda se valida con un conjunto de test local y con un panel de validación compartido que contiene señales sintéticas controladas para medir drift y regresión.
Resultado esperado: obtención de un modelo con rendimiento cercano al centralizado (pérdida controlada de 1–3% en AUC) pero con cumplimiento normativo y sin intercambio de historiales.
Implementación práctica y pasos accionables
Para pasar de la teoría a un despliegue con resultados medibles, seguir este plan mínimo:
Paso 1 — Evaluación inicial: identificar qué datos permanecen en origen, estimar la heterogeneidad y medir recursos de cómputo y red en los nodos potenciales.
Paso 2 — Prototipo controlado: iniciar una prueba con pocos clientes representativos, definir métricas de éxito y límites de comunicación por ronda.
Paso 3 — Seguridad y gobernanza: diseñar políticas de acceso, cifrado y auditoría; definir controles contra envenenamiento y planes de respuesta.
Paso 4 — Escalado y monitorización: planificar la incorporación progresiva de nodos, monitorizar convergencia, consumo de recursos y drift del modelo.
Herramientas y frameworks: existen implementaciones y bibliotecas que aceleran el desarrollo, pero la selección depende de requisitos operativos. Priorizar soluciones que permitan experimentación rápida y capacidades de cifrado y auditoría integradas.
Conclusión
El aprendizaje federado es una alternativa sólida cuando la privacidad y la gobernanza de datos son prioritarias. Aporta ventajas tangibles: menor exposición de datos, personalización local y uso eficiente de recursos distribuidos. No es una panacea; requiere planificación para mitigar problemas de convergencia, comunicación y seguridad. Para avanzar, comenzar por un prototipo con métricas definidas, aplicar defensas básicas frente a ataques y diseñar la gobernanza del ciclo de vida del modelo. Con esos pasos, el aprendizaje federado puede transformar proyectos que antes parecían imposibles por restricciones legales o de privacidad, manteniendo control y trazabilidad sin sacrificar rendimiento.