algoritmo de dijkstra: guía práctica, complejidad y caso aplicado

El algoritmo de dijkstra es el método clásico para encontrar caminos mínimos desde un nodo origen en grafos con pesos no negativos. Más allá de la definición teórica, conviene entender cuándo ofrece ventajas operativas, qué estructuras de datos aceleran su ejecución y qué errores frecuentes se deben evitar en implementaciones reales.
Introducción práctica al algoritmo de Dijkstra
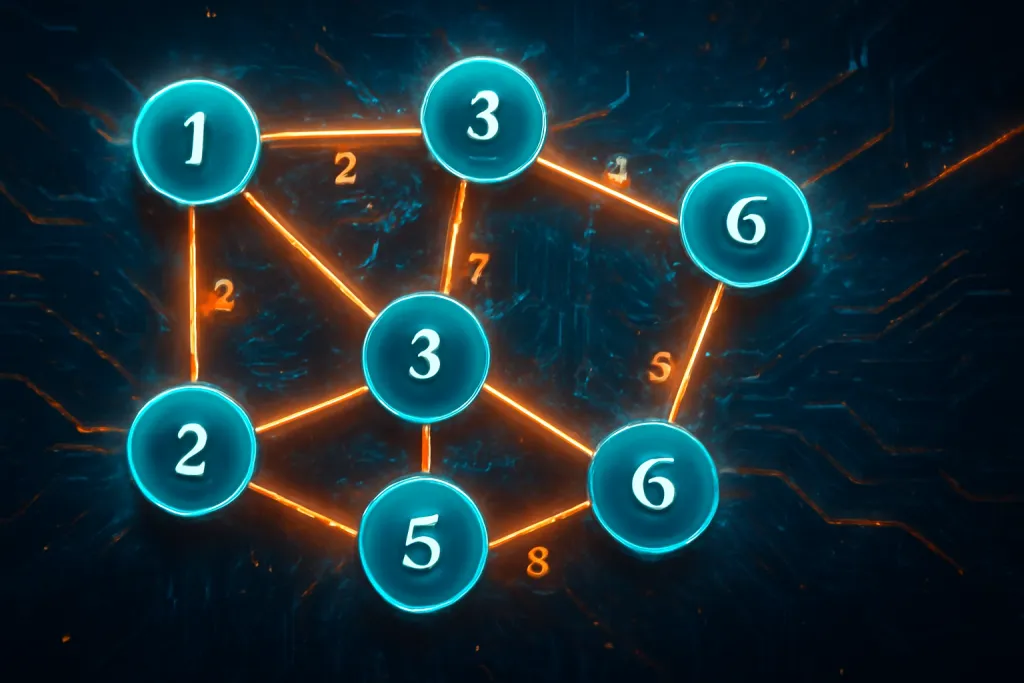
En aplicaciones como enrutamiento de paquetes, planificación de rutas en logística o análisis de redes urbanas, la necesidad es identificar el camino con menor coste entre un origen y múltiples destinos. El algoritmo de dijkstra resuelve precisamente ese problema para grafos ponderados con costes no negativos. Funciona de forma iterativa, seleccionando el vértice con la distancia provisional mínima y relajando las aristas adyacentes.
Cómo funciona paso a paso
La idea central es mantener, para cada vértice, la distancia mínima conocida desde el origen y una marca de visitado que impide revisitar vértices cuyo mínimo ya fue confirmado. A continuación se presenta una secuencia operativa clara para una implementación típica:
- Inicializar la distancia de todos los vértices a infinito, salvo la del origen fijada en cero.
- Insertar el origen en una cola de prioridad ordenada por distancia provisional.
- Extraer el vértice con menor distancia provisional; si ya fue procesado, ignorarlo.
- Para cada vecino no procesado, calcular distancia alternativa = distancia actual + peso(arista). Si es menor que la almacenada, actualizar la distancia y el predecesor, y actualizar su posición en la cola de prioridad.
- Repetir hasta procesar todos los vértices o hasta extraer la distancia del destino deseado si se busca camino único.
Este procedimiento garantiza que, una vez que un vértice se extrae de la cola como el mínimo, su distancia es definitiva.
Complejidad, estructuras de datos y variantes implementables
La complejidad depende de la representación del grafo y de la cola de prioridad. Consideraciones prácticas:
- Lista de adyacencia + cola binaria (heap): O((E + V) log V). Es la combinación estándar para grafos dispersos.
- Matriz de adyacencia + selección lineal del mínimo: O(V^2). Adecuada para grafos densos o cuando V es pequeño.
- Montículos de Fibonacci reducen la complejidad teórica a O(E + V log V), pero suelen ser menos eficaces en implementaciones prácticas por la sobrecarga constante.
Variantes útiles:
- Dijkstra con parada temprana: si solo interesa la distancia a un destino, detener al extraer ese vértice.
- Multi-origen: inicializar varias fuentes con distancia cero para problemas de multiple-sourcing.
- Aplicaciones en grafos dinámicos: mantener estructuras que permitan actualizaciones incrementales de pesos cuando las aristas cambian.
Cuándo conviene usar Dijkstra y cuándo no
Decidir entre Dijkstra y otros algoritmos depende de restricciones del problema y del grafo:
- Usar Dijkstra cuando los pesos son no negativos y se requiere la distancia mínima desde una fuente a todos los nodos o a un destino particular.
- Evitar Dijkstra si el grafo puede tener aristas con peso negativo: en ese caso, Bellman-Ford permite detectar ciclos negativos y calcular caminos mínimos.
- Si se busca la ruta más corta entre un par de nodos en grafos muy grandes con heurística admisible disponible (por ejemplo, distancia euclídea en mapas), A* suele ser más eficiente.
- Para hallar caminos mínimos entre todos los pares de vértices, Floyd-Warshall o algoritmos basados en múltiple ejecuciones de Dijkstra (con optimizaciones) son alternativas a evaluar según densidad y tamaño del grafo.
Ejemplo aplicado: diseño de rutas en una red de transporte urbano
Mini-caso: una ciudad con 40 paradas y 120 conexiones entre ellas. Cada arista representa tiempo de viaje estimado; todos los pesos son no negativos. Requisitos: calcular rutas óptimas desde la central de control hacia las paradas afectadas por un incidente en tiempo real.
Decisiones prácticas:
- Representación: lista de adyacencia para ahorrar memoria y acelerar iteración sobre vecinos.
- Cola de prioridad: heap binario estándar. Con V=40 y E=120, la sobrecarga de estructuras avanzadas no compensa.
- Parada temprana: como interesa solo llegar a un subconjunto reducido de paradas, detener cuando todas estén confirmadas reduce tiempo.
Resultado esperado: tiempos de cálculo en milisegundos que permiten actualizaciones en tiempo real. Si las actualizaciones de tráfico son frecuentes, conviene mantener una caché de distancias y recomputar solo para las regiones afectadas.
Errores comunes y recomendaciones para producción
Al desplegar Dijkstra en sistemas reales, se observan fallos repetidos que afectan la exactitud o el rendimiento. A continuación, las más relevantes con soluciones prácticas:
- Usar pesos negativos sin validación: provoca resultados incorrectos. Validar pesos en la entrada y, si existen negativos, emplear Bellman-Ford o transformar el modelo del coste.
- No sincronizar actualizaciones en grafos concurrentes: en entornos multihilo, proteger estructuras con mecanismos de concurrencia o aplicar snapshots inmutables para cada cálculo.
- Manejo ineficiente de la cola de prioridad: realizar actualizaciones frecuentes sin disminuir la complejidad conduce a cuellos de botella. Usar decrease-key cuando la estructura lo soporte o reinsertar con marca de visitado para heaps que no lo permiten.
- Ignorar precisión numérica: en costes basados en medidas continuas, sumar pequeñas diferencias puede acumular error. Normalizar unidades y aplicar tolerancias al comparar distancias.
- No aprovechar la heurística cuando procede: para búsquedas punto a punto en espacio euclidiano, A* reduce nodos explorados manteniendo optimalidad con una heurística admisible.
Recomendaciones adicionales:
- Perfilar la aplicación con casos reales antes del despliegue para elegir la representación óptima del grafo.
- Registrar estadísticas de ejecución (nodos extraídos, tiempo por iteración) para identificar degradaciones en vivo.
- Preferir implementaciones probadas y testear con grafos extremos: muy dispersos, densos y con rutas largas.
Cierre: cómo avanzar tras implementar Dijkstra
Implementar el algoritmo de dijkstra correctamente exige más que traducir pseudocódigo: implica seleccionar la estructura de datos adecuada, validar supuestos sobre pesos y optimizar para el patrón de consulta esperado. Para sistemas en producción, incorporar pruebas con datos reales, métricas de rendimiento y manejo robusto de concurrencia reduce riesgos operativos. Adoptar variantes —parada temprana, multi-origen o integración con heurísticas— permite adaptar Dijkstra a necesidades concretas sin sacrificar exactitud.
El control sobre esos detalles garantiza que el algoritmo de dijkstra no sea solo una solución teórica, sino una herramienta eficaz para resolver problemas de enrutamiento y optimización en entornos reales.