mongodb es sql o nosql: diferencias y cuándo elegirlo

mongodb es sql o nosql es una duda habitual al elegir una base de datos para una aplicación. La respuesta corta es que MongoDB es una base de datos NoSQL orientada a documentos. No organiza la información principalmente en tablas y filas, como ocurre con una base de datos relacional, aunque permite realizar consultas complejas y trabajar con transacciones. Para decidir si encaja, conviene mirar más allá de la etiqueta y entender cómo representa los datos, qué consultas necesita la aplicación y qué coste tendría mantener ese modelo.
La respuesta breve: MongoDB es NoSQL, no una base SQL
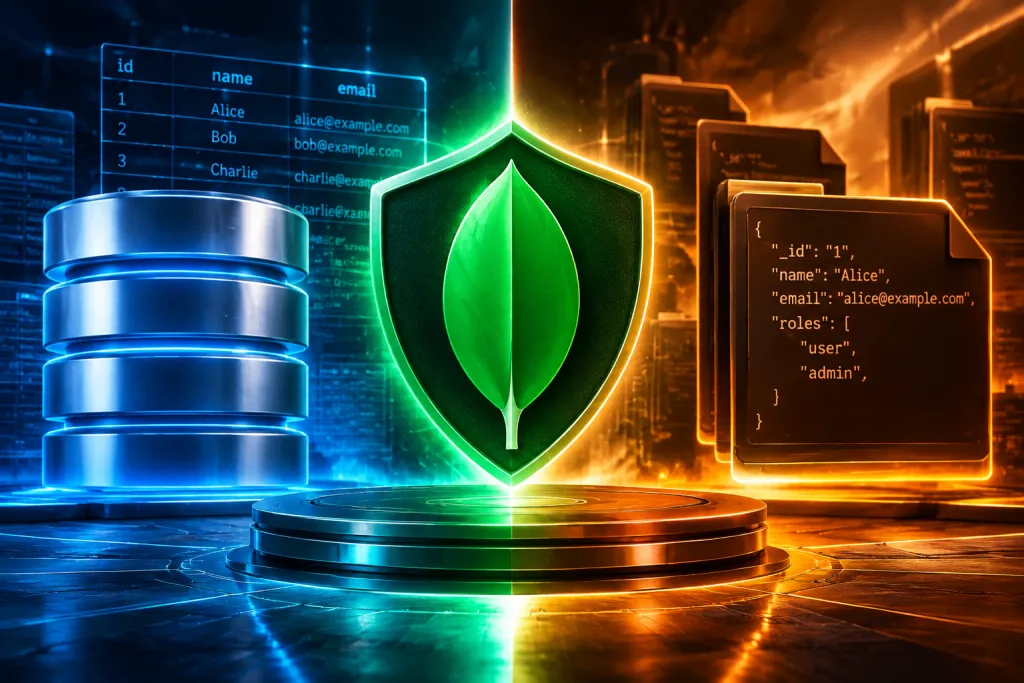
MongoDB almacena registros como documentos BSON, una representación binaria de datos con una estructura parecida a JSON. Un documento puede contener campos, listas y objetos anidados. Por ejemplo, una ficha de producto podría guardar el nombre, el precio, las categorías y algunas características dentro de un mismo documento.
En una base de datos relacional, esa misma información podría repartirse entre varias tablas, como productos, categorías y características, conectadas mediante claves. Ninguno de los dos modelos es automáticamente mejor: cada uno facilita unas tareas y obliga a resolver otras de manera distinta.
La clasificación NoSQL tampoco significa que MongoDB carezca de estructura o de controles. Los documentos de una colección pueden tener campos diferentes, pero una aplicación puede imponer reglas mediante validación de esquemas. La flexibilidad es una opción de diseño, no una obligación de aceptar cualquier dato sin revisión.
Por qué su lenguaje de consulta no lo convierte en SQL
Parte de la confusión viene de que MongoDB permite buscar, filtrar, ordenar y transformar datos mediante una API de consultas. También ofrece operadores y etapas de agregación con los que se pueden resolver análisis elaborados. Sin embargo, su lenguaje habitual no es SQL y el modelo de almacenamiento sigue siendo documental.
En SQL, una consulta suele expresar operaciones sobre tablas y relaciones. En MongoDB, las operaciones se aplican sobre colecciones de documentos, con filtros que describen campos y valores. La agregación permite encadenar transformaciones, agrupar resultados y calcular métricas. Puede cubrir necesidades que, en un sistema relacional, resolverían consultas SQL, pero la sintaxis y algunas decisiones de modelado son distintas.
Conviene separar dos conceptos: SQL es un lenguaje de consulta asociado a bases relacionales; NoSQL agrupa modelos de datos que no se basan en el esquema tabular relacional tradicional. Que MongoDB permita consultar datos con flexibilidad no lo convierte en una base SQL. Del mismo modo, que una base sea NoSQL no implica que solo sirva para búsquedas simples.
El modelo documental cambia la forma de diseñar la aplicación
La decisión más relevante no es aprender una sintaxis, sino determinar qué información conviene leer y actualizar junta. MongoDB funciona bien cuando los datos relacionados se consumen como una unidad y pueden representarse de forma natural en un documento.
Imagina una plataforma de comercio electrónico que muestra la página de un producto con su nombre, precio, imágenes y especificaciones. Si esos datos suelen consultarse juntos y las especificaciones varían según la categoría, un documento puede evitar parte del trabajo de combinar múltiples tablas. Un producto electrónico puede incluir capacidad y voltaje; una prenda, talla y composición.
Ese diseño no significa que se deba guardar todo anidado. Si una categoría tiene miles de productos, cambia de forma independiente o se administra como entidad propia, duplicarla dentro de cada documento puede crear inconsistencias. También hay límites prácticos: el tamaño máximo de un documento BSON es de 16 MiB. Por eso no conviene añadir indefinidamente listas que crecen sin control, como el historial completo de actividad de una cuenta.
Una regla útil es empezar por los patrones de acceso: qué pantallas, informes o procesos consultan los datos, qué campos se actualizan y con qué frecuencia. Después se decide qué se incrusta en un documento y qué se mantiene en otra colección con una referencia. El modelado documental debe responder al uso real, no a la idea de que toda duplicación es mala o de que todo debe estar junto.
Transacciones, relaciones y consistencia: los matices que importan
MongoDB admite transacciones multidocumento en configuraciones compatibles. Esto permite agrupar varias operaciones para que se confirmen o se deshagan como una unidad. Es una capacidad importante, pero no hace que MongoDB se comporte exactamente como una base relacional ni elimina la necesidad de diseñar bien los datos.
Si una operación actualiza documentos de varias colecciones de manera frecuente, merece la pena comprobar si el modelo está creando complejidad evitable. En ocasiones se puede reorganizar la información para que los cambios relacionados afecten a un único documento. En otras, la transacción es la opción adecuada porque los datos deben conservar una coherencia estricta entre varias entidades.
MongoDB también permite combinar datos de colecciones, por ejemplo mediante la etapa $lookup de las agregaciones. Es útil, pero una aplicación con consultas que dependen constantemente de numerosas relaciones puede encajar mejor en un esquema relacional. Las uniones no están prohibidas en MongoDB; simplemente no deberían darse por supuestas como el centro de cada diseño sin evaluar su coste y frecuencia.
Antes de elegir, hay que identificar qué significa consistencia para el negocio. Un catálogo puede tolerar que una cifra agregada se actualice con cierto retraso; el saldo de una cuenta o el inventario reservado para una compra puede requerir controles más estrictos. La tecnología debe ajustarse a esas reglas, no al revés.
Cuándo conviene MongoDB y cuándo mirar una base relacional
MongoDB suele ser una opción razonable cuando el esquema evoluciona con rapidez, los registros tienen variaciones legítimas o la aplicación trabaja principalmente con documentos completos. También puede encajar en catálogos con atributos heterogéneos, gestión de contenido, perfiles de usuario y sistemas que reciben eventos o datos semiestructurados.
Por ejemplo, una plataforma de contenidos puede tener artículos, vídeos y documentos con campos propios. Forzar todos los tipos en una estructura rígida puede generar muchas columnas vacías o tablas auxiliares. Con documentos, cada tipo puede conservar los campos relevantes, mientras la aplicación mantiene validaciones para que la variabilidad no se convierta en desorden.
Una base relacional como PostgreSQL suele ser preferible cuando las relaciones entre entidades son centrales, hay numerosas consultas que combinan tablas o existen reglas complejas de integridad referencial. También es una elección sólida para procesos financieros y operativos donde el equipo ya conoce bien el modelo relacional y necesita aprovechar sus capacidades de consulta y restricciones.
La decisión no tiene que basarse en una moda tecnológica. Para un sistema pequeño con datos estructurados y relaciones claras, una base relacional puede ofrecer un camino más sencillo. Para una aplicación documental con estructuras variables, MongoDB puede reducir fricción. Y en algunos sistemas se emplean varios almacenes, pero esa arquitectura añade operación, sincronización y puntos de fallo: solo compensa si existe una necesidad concreta.
Errores frecuentes al escoger MongoDB
- Confundir flexibilidad con ausencia de diseño. Sin convenciones, validación y control de cambios, los documentos pueden terminar con nombres distintos para el mismo dato o con versiones incompatibles.
- Duplicar información sin definir cómo se actualiza. Copiar el nombre de una categoría dentro de muchos productos puede acelerar lecturas, pero obliga a propagar los cambios o aceptar que algunos documentos queden desactualizados.
- Ignorar los índices. Un filtro sobre un campo sin índice adecuado puede volverse costoso al crecer la colección. Los índices mejoran ciertas lecturas, pero consumen espacio y añaden trabajo a las escrituras; deben elegirse según las consultas reales.
- Tratar cada colección como una tabla tradicional. Copiar un esquema relacional sin aprovechar documentos anidados puede producir demasiadas consultas y referencias. A la inversa, incrustarlo todo puede crear documentos grandes y actualizaciones difíciles.
- Elegir por una prueba de rendimiento aislada. Un resultado depende del volumen, los índices, el patrón de lectura y escritura, la configuración y la forma de medir. Una prueba útil reproduce cargas representativas, no solo una consulta favorable.
Antes de migrar, resulta práctico elaborar una pequeña prueba con los flujos más importantes: una lectura habitual, una actualización frecuente, una consulta de informes y un caso que requiera coherencia entre varias entidades. Ese ejercicio descubre antes de producción si el modelo documental simplifica el sistema o si obliga a reconstruir demasiadas relaciones.
Una decisión basada en los datos y las consultas
La respuesta a mongodb es sql o nosql es clara: MongoDB es NoSQL y está orientado a documentos. La decisión de utilizarlo, en cambio, depende del modo en que la aplicación organiza y consulta la información. No basta con que el esquema parezca flexible; hay que comprobar que los documentos representan bien las operaciones cotidianas y que las reglas de consistencia están cubiertas.
Como siguiente paso, define las consultas principales, identifica qué datos se leen juntos y marca las relaciones que deben mantenerse siempre coherentes. Si los documentos reflejan esos patrones sin duplicaciones difíciles de gobernar, MongoDB puede ser una buena elección. Si predominan las relaciones cruzadas, las restricciones entre entidades y las consultas tabulares, compara seriamente una base relacional antes de comprometer el diseño.