

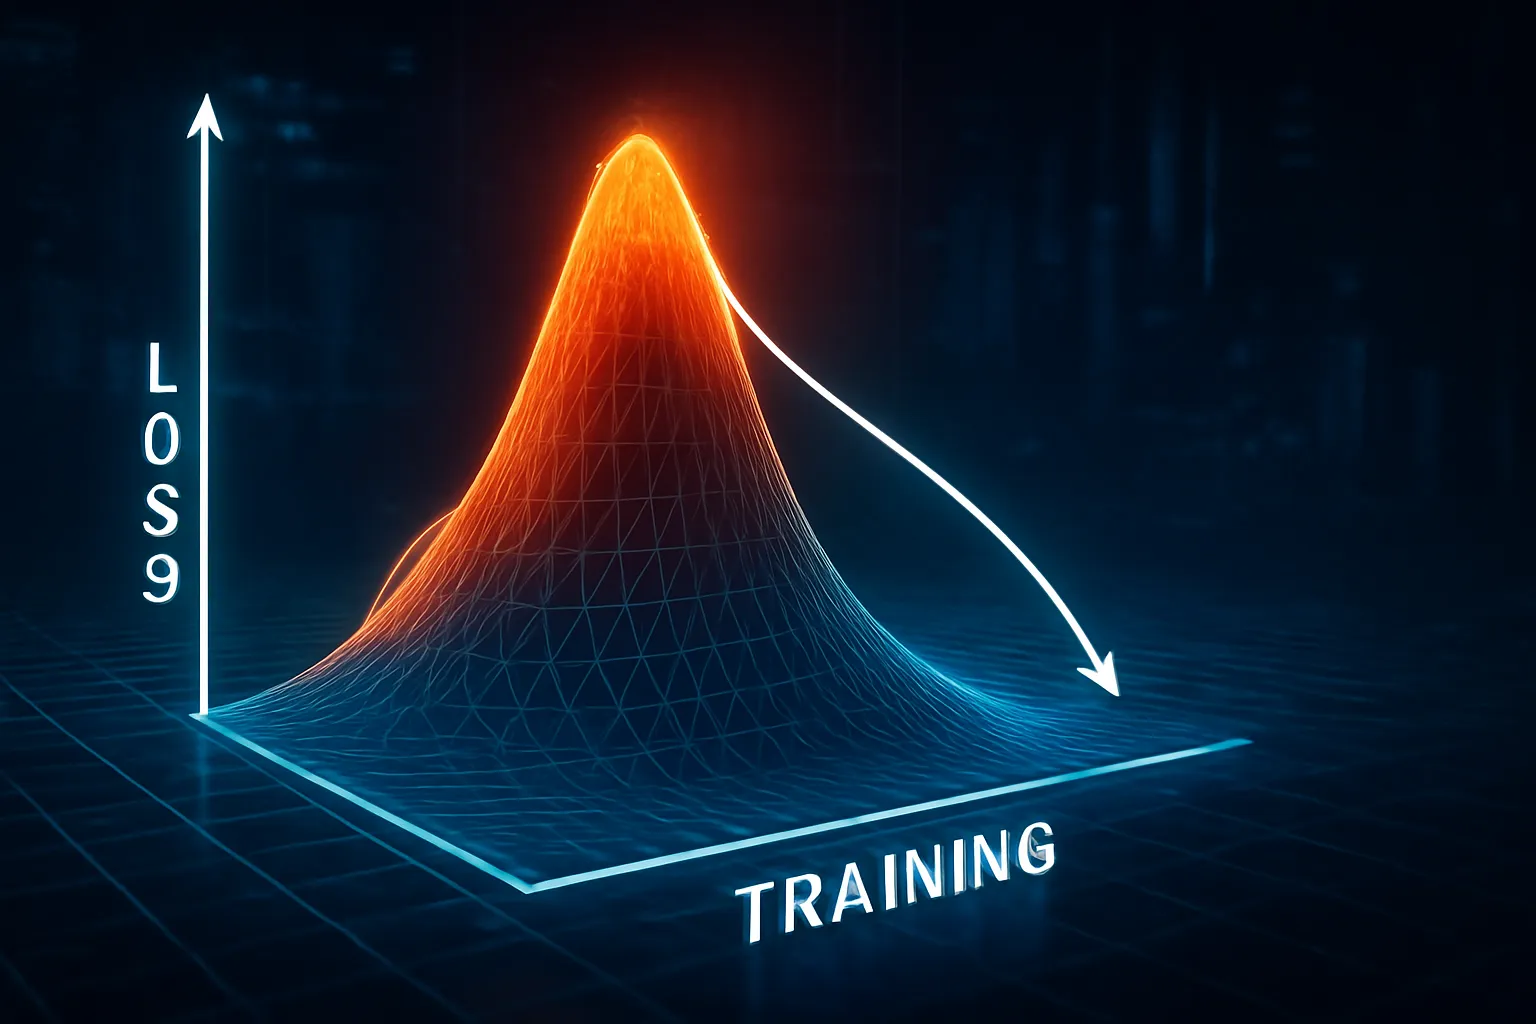
¿Qué es la función de pérdida y cómo afecta al entrenamiento?

Imagina que estás tratando de enseñar a un perro a hacer trucos. Cada vez que lo haces bien, lo recompensas con una golosina, pero si se equivoca, no le das nada. Este principio básico de recompensa y penalización es similar a lo que sucede en el mundo del aprendizaje automático a través de la función de pérdida. Pero, ¿qué es realmente esta función y cómo afecta el entrenamiento de los modelos? Vamos a descubrirlo.
¿Qué es la función de pérdida?
La función de pérdida, también conocida como función de costo, es una herramienta matemática que permite medir qué tan bien está realizando una tarea un modelo de machine learning. En términos simples, se trata de un indicador que nos dice cuán lejos está nuestra predicción de la realidad.
Imagina que estás prediciendo el precio de una casa. Tu modelo dice que una casa debería costar 200,000 euros, pero en la realidad, el precio es de 250,000 euros. La función de pérdida cuantificaría esta diferencia, arrojando un número que refleja el error de tu predicción.
Tipos de funciones de pérdida
Existen varias funciones de pérdida que se utilizan dependiendo del tipo de problema que se esté resolviendo. Aquí te mencionamos algunas de las más comunes:
1. Función de Pérdida de Error Cuadrático Medio (MSE)
La MSE es una de las funciones de pérdida más utilizadas en problemas de regresión. Se calcula tomando el promedio de los cuadrados de las diferencias entre las predicciones y los valores reales. Su fórmula es:
MSE = (1/n) * Σ(y_i – ŷ_i)²
Donde y_i son los valores reales y ŷ_i son las predicciones. Al elevar al cuadrado las diferencias, la MSE penaliza errores más grandes, lo cual puede ser útil.
2. Función de Pérdida de Entropía Cruzada
La entropía cruzada es utilizada en problemas de clasificación. Mide la disimilitud entre la distribución de probabilidad real y la predicha por el modelo. En este caso, se busca minimizar la incertidumbre en la clasificación. Su fórmula es:
CE = -Σ(y_i * log(ŷ_i))
Esta función es muy popular en redes neuronales y tareas de clasificación multiclase.
3. Funciones de Pérdida Hinge
Común en máquinas de soporte vectorial, la función de pérdida hinge se utiliza para problemas de clasificación. Se basa en el margen de separación entre las clases, siendo útil para realizar clasificaciones más robustas.
¿Cómo afecta la función de pérdida al entrenamiento?
La función de pérdida es crucial para el proceso de entrenamiento de un modelo. Comprender cómo afecta puede ser la clave para mejorar el rendimiento del mismo:
1. Guía la optimización
Durante el entrenamiento, el modelo intenta minimizar la función de pérdida a través de algoritmos de optimización como descenso por gradiente. Este algoritmo ajusta los parámetros del modelo para reducir el error y mejorar las predicciones.
2. Evalúa la calidad del modelo
La función de pérdida actúa como una métrica para evaluar qué tan bien está funcionando un modelo. Un valor bajo de pérdida indica un buen rendimiento, mientras que un valor alto sugiere que el modelo necesita ajustes.
3. Influye en la selección de hiperparámetros
Los hiperparámetros como la tasa de aprendizaje y el número de capas en una red neuronal se eligen también considerando la función de pérdida. Por lo tanto, una buena comprensión de ella puede llevar a la selección adecuada de estos parámetros, optimizando el proceso de entrenamiento.
Conclusión
En resumen, la función de pérdida es una pieza fundamental en el rompecabezas del aprendizaje automático. Afecta todos los aspectos del entrenamiento, desde la optimización hasta la evaluación del modelo. Comprender cómo funciona y cómo se aplica puedes ser vital para cualquier proyecto en el que estés trabajando. No subestimes su poder; después de todo, es la guía que dirige a tu modelo hacia la mejora continua. ¡Ahora es tu turno de aplicar este conocimiento y llevar tus modelos a otro nivel!




¡Qué interesante artículo! ¿Creen que la función de pérdida realmente impacta en el éxito del entrenamiento de redes neuronales? Yo creo que sí, pero ¿qué opinan ustedes? ¡Debatamos!
¡Vaya, interesante tema sobre funciones de pérdida! ¿Alguien más se confunde entre MSE y Entropía Cruzada? A veces siento que necesito un manual de instrucciones para entender todo esto. ¡Ayuda!
No te preocupes, es normal confundirse al principio. Sigue practicando y pronto lo dominarás. ¡Ánimo!
¡Vaya artículo interesante! ¿Creen que la función de pérdida MSE es más efectiva que la de Entropía Cruzada en el entrenamiento de modelos? ¡Quiero más debates sobre esto!
La Entropía Cruzada supera a MSE en muchos casos. Depende del problema y los datos. ¡Interesante debate!
¡Interesante artículo! ¿Realmente afecta mucho la función de pérdida en el entrenamiento? ¿Cuál es tu función de pérdida favorita para redes neuronales? ¡Quiero probarlas todas! 🤔🧠📊
¡Vaya tema interesante! ¿Creen que la función de pérdida afecta más al entrenamiento en redes neuronales que en otros modelos de aprendizaje automático? Personalmente, me intriga cómo influye en la convergencia del algoritmo. ¡Opiniones!
No creo que la función de pérdida sea tan determinante. Otros factores también influyen. Interesante debate.
¡Vaya tema interesante! ¿Alguien más piensa que la Entropía Cruzada es más efectiva en ciertos casos que el Error Cuadrático Medio? ¡Quiero escuchar opiniones! 🧐🤔
¡Totalmente de acuerdo! La Entropía Cruzada ofrece mejores resultados en problemas de clasificación. ¡Es fascinante! 😄
¡Qué interesante tema! Personalmente, pienso que la función de pérdida es crucial en el entrenamiento de modelos. Me pregunto ¿cuál crees que es más efectiva, la MSE o la Entropía Cruzada? ¡Debate abierto!
¡Vaya, menudo lío con estas funciones de pérdida! ¿Alguien más se siente un poco confundido con tanta información técnica? A ver si alguien puede explicarlo de forma más sencilla.
¡Parece que alguien necesita una clase de resumen! ¿Quién se anima a simplificarlo? 😉