redes neuronales profundas: cómo elegirlas y aplicarlas con criterio

Las redes neuronales profundas permiten reconocer patrones complejos en imágenes, texto, audio y otros datos, pero no son una solución automática para cualquier problema. Su utilidad depende de que exista una tarea bien definida, datos adecuados y una forma concreta de comprobar si el modelo mejora una decisión. Entender cómo trabajan ayuda a distinguir una aplicación valiosa de un proyecto costoso que solo añade complejidad.
Para una empresa, un equipo técnico o una persona que está aprendiendo inteligencia artificial, la pregunta práctica no es solo cómo se entrena una red, sino cuándo conviene usarla frente a métodos más sencillos. La respuesta exige revisar el tipo de información disponible, el margen de error aceptable y los recursos necesarios para mantener el sistema después de ponerlo en funcionamiento.
De los datos a las representaciones: qué hace profunda a una red
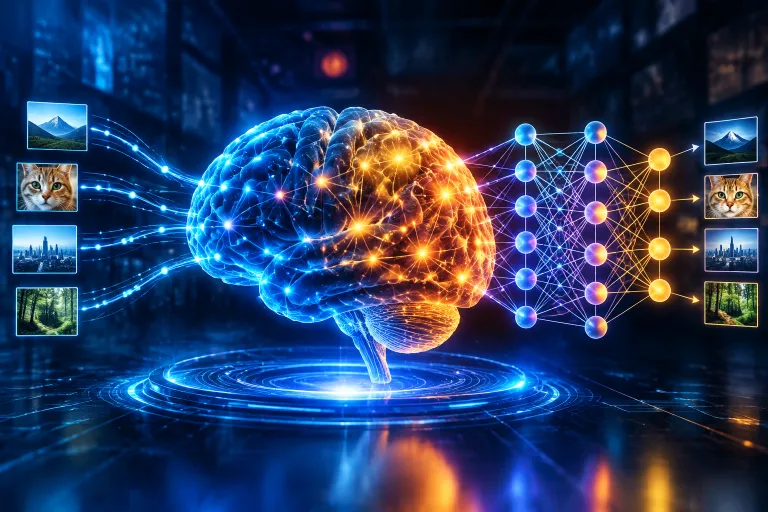
Una red neuronal artificial está formada por unidades matemáticas conectadas que transforman una entrada en una salida. En una tarea de clasificación, por ejemplo, puede recibir una fotografía y asignar probabilidades a categorías como “gato”, “perro” o “ninguno de los anteriores”. Cada conexión tiene un peso que se ajusta durante el entrenamiento para reducir la diferencia entre la predicción y la respuesta esperada.
La profundidad se refiere, en términos generales, a la presencia de varias capas de transformación entre la entrada y la salida. Las primeras capas pueden detectar señales simples; las siguientes combinan esas señales para representar patrones más elaborados. En una imagen, una secuencia de este tipo puede pasar de bordes y texturas a formas, partes de objetos y, finalmente, categorías reconocibles. No significa que la red comprenda una imagen como lo haría una persona: aprende regularidades estadísticas que resultan útiles para la tarea asignada.
Durante el entrenamiento, el sistema compara sus predicciones con ejemplos etiquetados y modifica sus parámetros mediante algoritmos de optimización, como el descenso del gradiente y la retropropagación. El proceso se repite muchas veces. Si el conjunto de entrenamiento representa bien el problema, la red puede aprender patrones que también aparezcan en datos nuevos. Si contiene errores, sesgos o casos poco variados, esos defectos pueden reflejarse en el resultado.
Cuándo aportan una ventaja frente a modelos más simples
Las redes neuronales profundas suelen destacar cuando los datos son numerosos, complejos y poco estructurados. Fotografías, grabaciones, documentos y señales de sensores contienen relaciones difíciles de describir mediante reglas manuales. Una red puede aprender características directamente de esos ejemplos, mientras que un método tradicional a menudo requiere definir de antemano qué variables o patrones debe considerar.
Esto no convierte a los modelos profundos en la opción preferible por defecto. Para estimar la probabilidad de impago usando unas pocas variables tabulares, un modelo de regresión logística o un árbol de decisión puede ser suficiente, más fácil de explicar y más barato de mantener. En cambio, para detectar defectos visuales en una línea de producción con miles de imágenes etiquetadas, una red convolucional puede captar variaciones de forma y textura que serían difíciles de codificar como reglas.
Una comparación útil debe partir de una línea base sencilla. Se entrena primero un método de referencia con los mismos datos y se mide su rendimiento con una métrica relacionada con el coste real de los errores. Solo tiene sentido aumentar la complejidad si el modelo profundo ofrece una mejora relevante, no solo una cifra ligeramente superior en una prueba aislada. En una aplicación médica, por ejemplo, quizá importe reducir falsos negativos; en una recomendación de productos puede ser más valioso mejorar la relevancia sin empeorar la diversidad.
El proyecto empieza antes del entrenamiento
El primer trabajo consiste en definir qué decisión apoyará el modelo. “Analizar comentarios” es demasiado impreciso; “identificar mensajes que mencionan una avería para enviarlos al equipo de soporte” delimita mejor la tarea. También permite decidir qué se considera un acierto, qué ocurre cuando la predicción es incierta y quién revisará los casos dudosos.
Después se comprueba si los datos reflejan el uso previsto. Un conjunto puede contener millones de registros y seguir siendo inadecuado si procede de una única región, de un solo tipo de dispositivo o de un periodo atípico. Conviene separar los datos en entrenamiento, validación y prueba, evitando que registros casi idénticos aparezcan en más de una partición. Si se mezclan imágenes de una misma pieza entre entrenamiento y prueba, por ejemplo, el resultado puede parecer excelente sin demostrar que el sistema funciona con piezas nuevas.
En una aplicación de inspección industrial, un equipo podría reunir imágenes de componentes correctos y defectuosos. Sin embargo, si solo hay unas pocas fotos de defectos raros, la red puede aprender a clasificar casi todo como correcto y aun así mostrar una precisión global elevada. Revisar la sensibilidad para cada clase, la matriz de confusión y ejemplos de errores revela mejor el problema. Si el coste de dejar pasar un defecto supera el de una revisión manual adicional, el umbral de decisión deberá priorizar la detección, aunque aumenten las alertas.
La calidad del etiquetado también merece atención. Las etiquetas incoherentes introducen ruido que el modelo no puede resolver por sí solo. Cuando varios especialistas discrepan sobre una categoría, es necesario acordar criterios, documentar excepciones y, si procede, mantener una etiqueta de incertidumbre. Más datos no siempre arreglan un objetivo mal definido.
Arquitecturas distintas para problemas distintos
La arquitectura es la forma en que se organizan las capas y las conexiones. Algunas familias se ajustan mejor a ciertos tipos de información, aunque sus usos pueden solaparse:
- Redes convolucionales: se han utilizado ampliamente en visión por computadora para clasificar imágenes, localizar objetos o segmentar regiones. Aprovechan patrones espaciales locales, como bordes y texturas.
- Redes recurrentes y modelos secuenciales: procesan series ordenadas, como audio o mediciones a lo largo del tiempo. En muchas tareas modernas han sido reemplazados o complementados por arquitecturas de atención.
- Transformers: emplean mecanismos de atención para relacionar elementos de una secuencia. Se usan en procesamiento del lenguaje, visión y sistemas multimodales, y pueden aprovechar grandes volúmenes de datos.
- Redes para grafos: trabajan con entidades conectadas, como moléculas, redes sociales o relaciones entre productos y usuarios.
La arquitectura no se elige por popularidad, sino por la estructura de los datos, los recursos disponibles y el nivel de rendimiento necesario. También es posible aprovechar un modelo ya entrenado y adaptarlo a una tarea concreta, en lugar de entrenar desde cero. El aprendizaje por transferencia puede reducir el volumen de datos y el tiempo de cómputo, aunque no elimina la necesidad de validar el sistema en el contexto donde se usará.
Errores que convierten una buena demostración en un mal sistema
Un resultado prometedor en una prueba controlada no garantiza un servicio fiable. Uno de los fallos más comunes es el sobreajuste: la red memoriza rasgos particulares de los ejemplos de entrenamiento y funciona peor con casos nuevos. Se detecta comparando el rendimiento en entrenamiento con el de validación y prueba. Técnicas como la regularización, el abandono de unidades y la ampliación de datos pueden ayudar, pero no sustituyen a una evaluación bien diseñada.
Otro riesgo es la fuga de información. Ocurre cuando una variable revela indirectamente la respuesta que se intenta predecir, o cuando se usan datos futuros para simular una predicción que debería hacerse antes. En esos casos, las métricas se inflan. La división de datos debe reproducir el uso real: si el modelo se aplicará a clientes nuevos, separar al azar filas de un mismo cliente puede ofrecer una imagen engañosa de su rendimiento.
También hay que vigilar los cambios en los datos. Una cámara distinta, una nueva política comercial o un cambio en el comportamiento de los usuarios pueden alterar las condiciones que el modelo aprendió. Por eso, desplegar una red profunda requiere seguimiento: registrar predicciones, revisar muestras, medir errores por grupo y definir cuándo volver a entrenar. El modelo es parte de un proceso operativo, no un archivo que se entrega y se olvida.
La explicabilidad y la privacidad necesitan una evaluación específica. En decisiones de alto impacto, una predicción sin una justificación comprensible puede ser insuficiente, aunque sea precisa en promedio. Además, entrenar con información personal exige controles de acceso, minimización de datos y revisión de las obligaciones aplicables. Cuando esas condiciones no pueden cumplirse, conviene limitar el alcance del sistema o elegir una alternativa más transparente.
Cómo decidir si la inversión tiene sentido
El coste total no se limita al entrenamiento. Incluye preparación y almacenamiento de datos, infraestructura de inferencia, consumo energético, integración con aplicaciones, supervisión humana y mantenimiento. Un modelo grande puede ser técnicamente viable y, aun así, resultar demasiado lento o caro para una tarea que necesita responder en tiempo real. En otros casos, una red pequeña ejecutada localmente ofrece suficiente precisión y protege mejor la información.
Antes de aprobar un proyecto, conviene responder preguntas concretas: ¿qué error se pretende reducir?, ¿cuál es la alternativa actual?, ¿qué volumen y calidad tienen los datos?, ¿quién revisará las predicciones dudosas?, ¿cómo se medirá el beneficio después del despliegue? Una prueba piloto debe incluir condiciones cercanas a las reales y un criterio de salida. Si no mejora una métrica operativa —tiempo de inspección, incidencias detectadas o carga de revisión—, la sofisticación técnica no constituye por sí misma un retorno.
Las redes neuronales profundas son una herramienta potente para extraer patrones de datos complejos, especialmente en imagen, lenguaje y audio. Su rendimiento depende menos de la etiqueta de moda que de la formulación del problema, la representatividad de los datos y el control posterior. La decisión más sólida es comenzar con una línea base, medir los errores que realmente importan y escalar a un modelo profundo solo cuando la mejora compense su coste y sus riesgos.