¿Qué es la IA conexionista y cómo funciona? Una guía clara

¿Qué es la IA conexionista y cómo funciona? Es un enfoque de inteligencia artificial que aprende patrones a partir de ejemplos mediante redes de unidades conectadas, en lugar de depender únicamente de reglas escritas de forma explícita. Está detrás de tecnologías como el reconocimiento de voz, la clasificación de imágenes y muchos modelos de lenguaje. Entender su mecanismo ayuda a distinguir lo que puede resolver de aquello que requiere reglas, supervisión humana o datos que todavía no existen.
Del conocimiento escrito a los patrones aprendidos
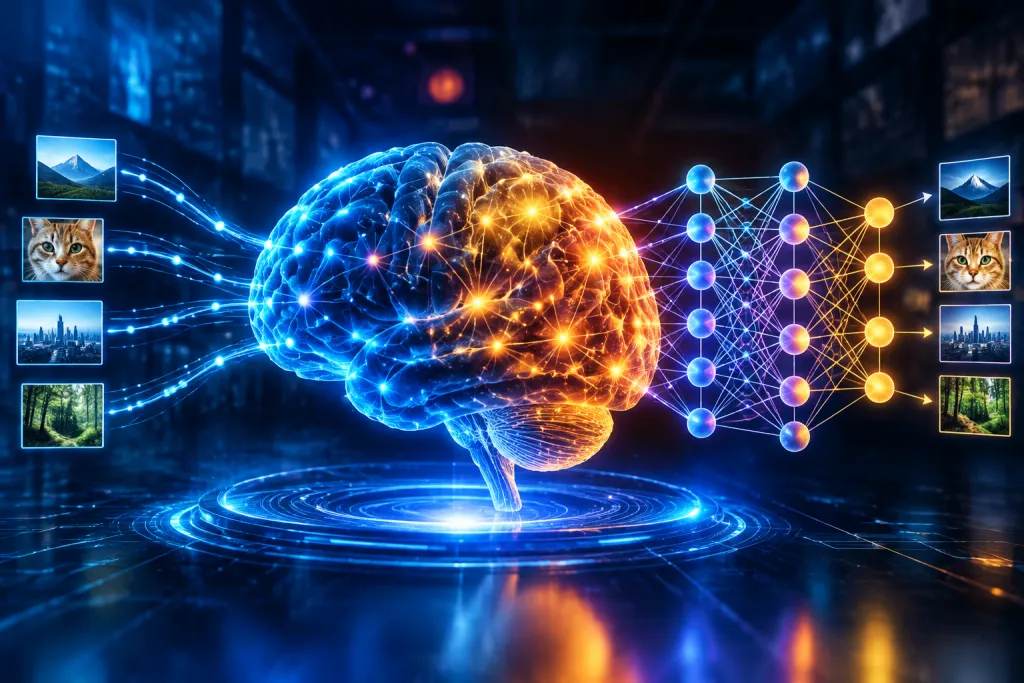
La IA conexionista se inspira, de manera simplificada, en la idea de que una actividad inteligente puede surgir de muchas unidades sencillas que intercambian señales. En una red neuronal artificial, esas unidades se organizan en capas y realizan operaciones matemáticas. Las conexiones entre ellas tienen valores llamados pesos, que determinan cuánto influye una señal en el resultado.
La diferencia con un sistema basado en reglas se aprecia con un ejemplo. Para identificar correos no deseados mediante reglas, alguien podría programar condiciones como “si el asunto contiene cierta palabra, marcarlo como spam”. Ese método es transparente, pero necesita que se anticipen los casos y se mantengan las reglas. Un modelo conexionista, en cambio, puede analizar muchos correos etiquetados como spam o legítimos y aprender combinaciones de indicios: vocabulario, remitente, estructura, enlaces y otros rasgos.
Esto no significa que la red comprenda un mensaje como lo haría una persona. Ajusta parámetros para detectar regularidades útiles según los datos y el objetivo definidos. Puede acertar en ejemplos parecidos a los que vio durante el entrenamiento y fallar ante situaciones nuevas, ambiguas o representadas de manera insuficiente.
Cómo aprende una red neuronal, paso a paso
El aprendizaje conexionista suele consistir en modificar los pesos de la red hasta que sus respuestas se aproximen a las respuestas esperadas. Para hacerlo se necesita una tarea concreta, un conjunto de datos y una medida del error. El proceso general puede describirse así:
- Se preparan ejemplos. Para entrenar un clasificador de imágenes, se reúnen fotografías y etiquetas, por ejemplo, “gato” o “perro”. La calidad, diversidad y pertinencia de esos ejemplos condicionan lo que podrá aprender el modelo.
- La red produce una predicción. Los datos se convierten en valores numéricos y atraviesan varias capas. Cada capa transforma la señal y transmite una representación a la siguiente.
- Se calcula el error. Una función de pérdida compara la predicción con la respuesta esperada. Si la red asigna mucha probabilidad a “gato” cuando la etiqueta correcta es “perro”, el error será mayor.
- Se ajustan los pesos. Algoritmos de optimización, habitualmente junto con retropropagación, calculan cómo modificar los parámetros para reducir el error. El ajuste se repite con numerosos ejemplos.
- Se evalúa con datos separados. El rendimiento se comprueba con casos que no se usaron para entrenar. Esta evaluación permite detectar si la red aprendió regularidades generalizables o si se limitó a memorizar detalles del conjunto de entrenamiento.
La retropropagación no es una explicación mágica de cómo “piensa” la red. Es un procedimiento matemático para distribuir información sobre el error hacia las conexiones que contribuyeron a la predicción. Durante el entrenamiento, la red actualiza sus parámetros; una vez desplegada, normalmente recibe entradas y genera salidas sin volver a aprender de cada consulta, salvo que exista un proceso de actualización diseñado para ello.
Un ejemplo concreto: detectar defectos en una línea de producción
Imaginemos una fábrica que fotografía piezas antes de empaquetarlas. Una solución conexionista puede aprender a distinguir piezas correctas de aquellas con grietas, deformaciones o manchas. Para entrenarla, se requieren imágenes representativas, incluidas variaciones de iluminación, posición, cámara y lote de producción. Si solo se muestran defectos muy visibles y siempre con el mismo fondo, el sistema puede aprender el fondo o las condiciones de la fotografía en vez de reconocer el daño.
En una prueba inicial, el modelo podría detectar bien los defectos habituales, pero pasar por alto una grieta poco común. También podría señalar como defectuosas piezas válidas cuando cambia la iluminación. Por eso no basta con anunciar un porcentaje de acierto: conviene analizar falsos positivos, falsos negativos y el coste de cada error. En una línea donde un defecto omitido genera una retirada de producto, quizá se prefiera revisar más piezas antes que dejar pasar fallos. En otro proceso, el exceso de alertas podría detener la producción y exigir un umbral distinto.
El sistema también debe integrarse con el trabajo real: definir quién revisa las alertas, cómo se registran los casos dudosos y cómo se incorpora información nueva. La red puede ayudar a priorizar inspecciones, pero no reemplaza por sí sola el control de calidad, la calibración de cámaras ni la responsabilidad sobre las decisiones.
Qué aporta frente a la IA simbólica y cuáles son sus límites
La IA conexionista resulta especialmente útil cuando los datos contienen patrones difíciles de describir con reglas precisas: imágenes, audio, texto y señales de sensores. Puede combinar indicios distribuidos y mejorar su desempeño al entrenarse con ejemplos adecuados. El enfoque simbólico, por su parte, representa conceptos y relaciones mediante reglas o estructuras explícitas. Puede ser conveniente cuando se necesita aplicar una norma exacta, explicar cada paso o garantizar que una operación siga condiciones definidas.
No son enfoques necesariamente incompatibles. En algunas soluciones se combinan modelos neuronales con reglas, bases de conocimiento o validaciones posteriores. Por ejemplo, una red puede extraer datos de una factura y un sistema de reglas puede comprobar que las sumas y los campos obligatorios sean coherentes. La combinación permite aprovechar la flexibilidad del aprendizaje estadístico sin dejar de imponer controles verificables.
La capacidad de aprender patrones trae límites concretos:
- Dependencia de los datos: etiquetas incorrectas, sesgos de selección o ejemplos escasos pueden distorsionar las predicciones. Un conjunto grande no es automáticamente un conjunto representativo.
- Explicabilidad limitada: en redes complejas puede ser difícil reconstruir por qué se produjo una respuesta específica. Las técnicas de interpretación ayudan, pero no siempre ofrecen una explicación causal completa.
- Fragilidad ante cambios: si cambian los productos, el lenguaje de los clientes, las cámaras o las condiciones del entorno, el rendimiento puede deteriorarse. Se necesita seguimiento y evaluación periódica.
- Coste de desarrollo y operación: recopilar datos, etiquetarlos, entrenar modelos y mantenerlos requiere tiempo, infraestructura y personal. Para una tarea pequeña, un conjunto de reglas puede ser más barato y fiable.
- Confusión entre correlación y causa: una red puede apoyarse en una señal accidental que aparece junto con el resultado, sin que esa señal lo provoque. Una predicción acertada no demuestra que el modelo haya identificado el mecanismo real.
Cuándo conviene aplicar este enfoque
La pregunta útil no es si una red neuronal es más avanzada, sino si el problema tiene características que justifican su uso. Suele ser una opción razonable cuando existe un volumen suficiente de ejemplos relevantes, la tarea admite cierto grado de incertidumbre y hay una forma objetiva de medir el desempeño. También es necesario que el beneficio esperado compense el coste de preparar datos, integrar el modelo y vigilarlo.
Antes de iniciar un proyecto, conviene concretar qué decisión ayudará a tomar el sistema. “Usar inteligencia artificial para mejorar la atención” es demasiado amplio; “clasificar consultas entrantes para asignarlas al equipo adecuado y medir los errores de derivación” permite definir datos, métricas y un piloto. Si el proceso se resuelve con una regla clara y estable, automatizarla directamente puede ser más sensato. Si cada caso exige una valoración crítica y un error tiene consecuencias graves, el modelo debería limitarse a apoyar a una persona, no a decidir sin supervisión.
Una implantación prudente empieza con una línea base sencilla, como reglas actuales o revisión manual. Después se prueba el modelo con datos separados y situaciones poco frecuentes, se compara el coste de los distintos errores y se fija un procedimiento para escalar los casos dudosos. Tras el lanzamiento, deben vigilarse cambios en los datos y revisarse las predicciones que afectan a clientes, empleados o seguridad. Sin esa supervisión, un buen resultado en una prueba inicial puede dar una falsa sensación de fiabilidad.
La decisión clave: elegir el método por el problema
La IA conexionista aprende representaciones y relaciones estadísticas a través de conexiones ajustables, por lo que puede abordar tareas donde las reglas explícitas se vuelven difíciles de mantener. Su funcionamiento depende de datos, objetivos de entrenamiento, evaluación y seguimiento; no de una comprensión humana automática. Para aprovecharla, hay que comprobar qué patrones aprende, cómo falla y quién responde cuando la predicción no es adecuada.
Así se responde de forma práctica a qué es la IA conexionista y cómo funciona: es una familia de métodos que ajusta redes neuronales con ejemplos para producir resultados útiles en tareas definidas. Antes de adoptarla, formule el problema, mida el coste de los errores y compare una red con alternativas más simples. Si el modelo aporta una mejora comprobable y puede mantenerse bajo control, tendrá sentido incorporarlo; si no, la complejidad añadida no es una ventaja.