Qué avances se esperan en inteligencia artificial en los próximos años

En los próximos años, la inteligencia artificial (IA) probablemente avanzará menos mediante una única tecnología capaz de hacerlo todo y más por la combinación de modelos especializados, herramientas conectadas y controles para utilizarlos en tareas concretas. Para las empresas, los cambios más relevantes serán la capacidad de trabajar con distintos tipos de información, ejecutar procesos con varios pasos y reducir el coste de algunas tareas. La velocidad y el alcance de cada avance dependerán de su fiabilidad, del coste de operación y de la facilidad para integrarlo en los sistemas existentes.
Estas tendencias no son garantías sobre cuándo llegará cada capacidad ni sobre su rendimiento en todos los sectores. Sirven para identificar qué tecnologías están evolucionando y qué condiciones debería comprobar una organización antes de incorporarlas.
Modelos que combinan texto, imágenes, voz y vídeo
Los sistemas multimodales procesan más de un tipo de información. En vez de limitarse a recibir texto, un modelo puede analizar una imagen, escuchar una grabación o relacionar una pregunta escrita con contenido visual. La evolución esperable es una interacción más integrada entre esos formatos, aunque las capacidades concretas variarán entre herramientas y versiones.
En un entorno profesional, esto podría servir para consultar documentación técnica escaneada, localizar información en una captura de pantalla o resumir una conversación grabada. Por ejemplo, una persona de soporte podría aportar una fotografía hipotética de un panel de error y pedir una explicación, siempre que la herramienta permita analizar imágenes y que la imagen no exponga datos sensibles.
La utilidad no consiste solo en interpretar más formatos. También importa que el modelo señale qué parte del material respalda una respuesta. Si no es posible rastrear la conclusión hasta una página, un fragmento de audio o un elemento visual, aumenta la dificultad de revisar un posible error. En documentos empresariales, los permisos de acceso y la protección de la información siguen siendo necesarios aunque la interfaz admita archivos de forma sencilla.
De responder preguntas a ejecutar tareas con agentes
Un agente de IA es un sistema que, además de generar respuestas, puede utilizar herramientas para avanzar en una tarea. Según su configuración, podría consultar una base de datos, buscar un documento, preparar un borrador o llamar a un servicio interno. Los avances previsibles se centran en coordinar mejor esos pasos y recuperarse de errores sin que una persona tenga que dirigir cada acción.
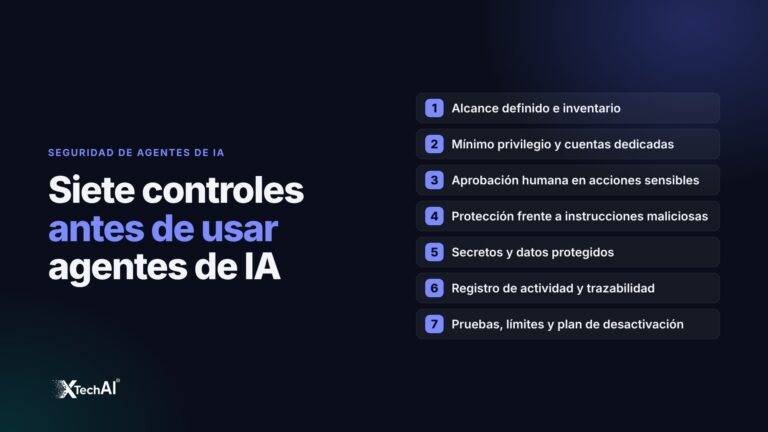
La diferencia con un chatbot convencional es importante: una respuesta incorrecta puede inducir a error, pero una acción equivocada también puede modificar registros, enviar información o iniciar un proceso. Por eso, automatizar no equivale a conceder acceso ilimitado. Una arquitectura prudente limita las operaciones disponibles, registra qué hizo el agente y solicita autorización humana antes de acciones sensibles o difíciles de revertir.
Cómo saber si un proceso está preparado
Un proceso es mejor candidato cuando sus entradas están definidas, los pasos se pueden describir y el resultado es verificable. Clasificar solicitudes y proponer una respuesta para revisión, por ejemplo, suele ser más controlable que permitir que un sistema gestione por su cuenta toda la relación con un cliente.
- Delimitar el alcance: especificar qué datos puede consultar el sistema y qué acciones tiene permitidas.
- Separar preparación y ejecución: dejar que la IA redacte o recomiende antes de autorizar cambios automáticos.
- Registrar las operaciones: conservar información suficiente para revisar qué herramienta se utilizó y qué resultado produjo.
- Definir una salida segura: establecer cuándo debe detenerse y derivar el caso a una persona.
Un ejemplo hipotético sería un agente que reúne datos de un pedido y redacta una propuesta de respuesta. Una persona revisa el texto antes de enviarlo y el sistema no puede cambiar la dirección de entrega. Ese diseño aporta automatización sin delegar una acción de impacto en un componente que podría interpretar mal una instrucción.
Modelos más pequeños y ejecución cerca de los datos
El desarrollo de IA no depende únicamente de modelos cada vez más grandes. También se trabaja en modelos más pequeños o especializados, técnicas de optimización y sistemas que combinan modelos con distintas capacidades. Un modelo reducido puede ser suficiente para clasificar documentos o detectar campos en formularios, tareas que no requieren generar razonamientos complejos.
Cuando una parte del procesamiento se ejecuta en un ordenador o dispositivo local, en lugar de enviar todas las solicitudes a un servicio remoto, puede reducirse la dependencia de la conexión y facilitar que determinados datos permanezcan dentro de la organización. Sin embargo, el procesamiento local también exige recursos de hardware, mantenimiento y controles de seguridad. No garantiza por sí mismo privacidad ni elimina la necesidad de proteger los equipos.
La decisión entre nube, infraestructura propia o un enfoque mixto debería partir de requisitos concretos: volumen de uso, sensibilidad de los datos, latencia aceptable, capacidad de mantenimiento y coste total. Un sistema puede combinar un modelo ligero para tareas rutinarias con otro más capaz para casos que requieren análisis adicional. Para que esa estrategia funcione, hay que definir cómo se derivan los casos entre modelos y cómo se revisa la calidad de cada resultado.
Más conexión con los datos de cada organización
Una vía relevante consiste en combinar modelos generales con documentación y datos empresariales. Una técnica habitual en esta clase de sistemas es la generación aumentada por recuperación, conocida por las siglas RAG: antes de responder, el sistema busca información en fuentes autorizadas y la incorpora al contexto de la consulta. La respuesta puede así apoyarse en documentación interna sin que el modelo tenga que haber aprendido esos contenidos durante su entrenamiento.
La calidad depende de elementos que a menudo reciben menos atención que el modelo: documentos actualizados, permisos coherentes, búsquedas que recuperen los fragmentos pertinentes y referencias que permitan comprobar la respuesta. Si la fuente está obsoleta o el usuario no debería acceder a ella, la generación de texto no corrige el problema de origen. En entornos con información sensible, los controles de acceso deben aplicarse también a la etapa de búsqueda.
Para una empresa, una primera prueba útil podría limitarse a un conjunto acotado de manuales o procedimientos. Antes de ampliar el acceso, habría que comprobar si encuentra el documento adecuado, si diferencia instrucciones vigentes de versiones antiguas y si reconoce cuándo no dispone de información suficiente. El objetivo no es que la IA responda siempre, sino que responda con apoyo verificable o deje claro que hace falta revisar el caso.
Evaluación, seguridad y supervisión como parte del producto
Cuanto más participa la IA en actividades operativas, más importante resulta medir su comportamiento con ejemplos representativos del trabajo real. Una demostración favorable no permite saber cómo responderá ante documentos incompletos, peticiones ambiguas o excepciones poco frecuentes. Las pruebas deben incluir resultados correctos, errores previsibles y situaciones en las que el sistema debería abstenerse.
También se espera que ganen peso las herramientas de seguimiento: registros de uso, comparación entre versiones, límites de acceso y mecanismos para detener o revertir acciones. Estos controles permiten detectar si una actualización empeora una tarea o si las respuestas fallan en un grupo de situaciones concreto. No sustituyen la revisión humana cuando el resultado afecta a derechos, seguridad, dinero o decisiones importantes.
La seguridad tiene un reto adicional: un modelo puede recibir instrucciones ocultas en contenido externo, como un documento o una página web. Si dispone de herramientas conectadas, una instrucción maliciosa podría intentar inducirle a compartir información o ejecutar una operación no prevista. Reducir ese riesgo exige separar los datos consultados de las instrucciones de control, limitar permisos y pedir confirmación para acciones sensibles. La respuesta del modelo no debería tratarse como una barrera de seguridad suficiente.
Qué preparar antes de adoptar una nueva capacidad
Las empresas no necesitan esperar a que exista una IA general para obtener resultados. Pueden identificar una tarea repetitiva y acotada, establecer una referencia de cómo se realiza hoy y probar la herramienta con datos autorizados. La comparación debe atender tanto a la calidad como al tiempo de revisión, los errores que obligan a rehacer trabajo y los costes de integración y mantenimiento.
- Elegir una tarea concreta: evitar objetivos vagos como «automatizar la oficina» y describir una actividad con entradas y resultados identificables.
- Crear casos de prueba: incluir ejemplos habituales, excepciones y datos incompletos; no basar la evaluación solo en demostraciones preparadas.
- Determinar el coste de un error: decidir qué resultados necesitan aprobación y cuáles pueden ejecutarse de forma automática.
- Revisar la integración: comprobar permisos, registros, tratamiento de datos y capacidad de volver al procedimiento anterior.
- Ampliar solo con evidencia: medir si la herramienta mejora el proceso completo, no únicamente la rapidez con que genera una respuesta.
El avance más práctico de la IA en los próximos años probablemente será una incorporación gradual a programas, flujos de trabajo y dispositivos que ya se utilizan. Para distinguir una mejora útil de una promesa, la pregunta decisiva es concreta: qué tarea resuelve, con qué datos, bajo qué permisos y cómo se detecta y corrige un fallo.