bases de datos no relacionales: cómo elegir la adecuada para tu proyecto

Las bases de datos no relacionales pueden ser una buena elección cuando una aplicación maneja grandes volúmenes de información, necesita responder con rapidez o trabaja con datos cuya estructura cambia con frecuencia. Pero no son una solución automática para cualquier problema: elegirlas sin entender las consultas y las garantías necesarias puede generar más complejidad que beneficio.
La decisión adecuada empieza por una pregunta práctica: ¿cómo se guardarán, consultarán y modificarán los datos en el sistema real? A partir de ahí se puede comparar una base documental, una clave-valor, una orientada a columnas o una de grafos con una base relacional. Esta guía explica esas diferencias, incluye un caso de uso y ofrece criterios para decidir sin dejarse llevar por modas tecnológicas.
La decisión depende del acceso a los datos, no de una etiqueta
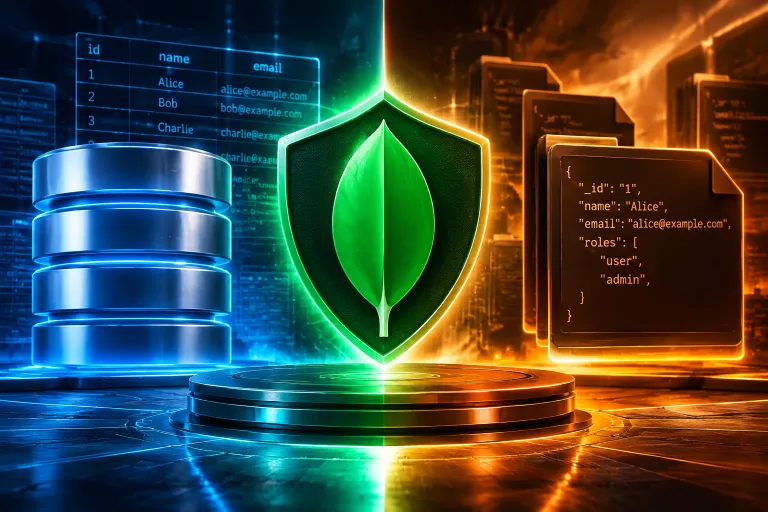
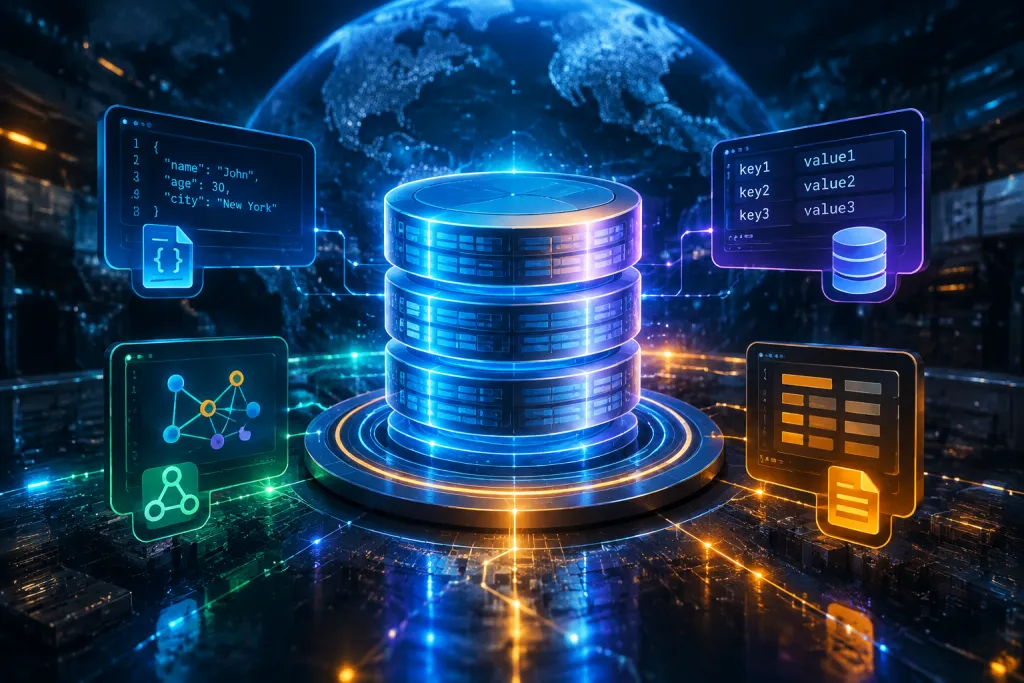
Una base de datos no relacional, también llamada NoSQL, es un sistema de almacenamiento que no organiza toda la información exclusivamente en tablas relacionadas mediante filas y columnas. El término reúne modelos distintos: algunos guardan documentos, otros pares de clave y valor, estructuras de grafo o registros distribuidos por familias de columnas.
Eso no significa que estos sistemas carezcan de estructura. Cada uno impone sus propias reglas sobre cómo representar la información, indexarla y recuperarla. La diferencia está en que suelen permitir modelos más flexibles o especializados que el esquema tabular tradicional, y en que sus mecanismos de escalado y consulta responden a necesidades diferentes.
Por ejemplo, una tienda puede consultar productos por identificador, categoría y disponibilidad. Si esas lecturas dominan el uso de la aplicación, quizá convenga guardar los datos de cada producto juntos en un documento. En cambio, si el sistema necesita cruzar con frecuencia pedidos, clientes, facturas y reglas de negocio complejas, la estructura relacional puede resultar más natural y segura.
Antes de escoger tecnología, conviene anotar las operaciones más frecuentes: qué datos se leen, qué filtros se aplican, cuántos registros se modifican juntos y qué nivel de consistencia requiere cada proceso. Una base de datos se adapta mejor cuando su modelo coincide con esos patrones, no cuando se elige por una cifra de rendimiento aislada.
Cuatro modelos que resuelven problemas diferentes
Documentos para objetos con atributos variables
Las bases documentales guardan registros como documentos, a menudo en formatos similares a JSON. Un producto puede incluir nombre, precio, fotografías y atributos específicos de su categoría sin obligar a que todos los productos compartan exactamente las mismas columnas. Este modelo resulta útil para catálogos, perfiles, contenido y aplicaciones cuyos campos evolucionan.
La flexibilidad tiene un coste potencial: si se duplican datos en varios documentos, una modificación puede exigir actualizar más de un lugar. También hay que diseñar con cuidado las consultas. Un documento cómodo de guardar no siempre es cómodo de filtrar, indexar o mantener cuando crece el volumen.
Clave-valor para lecturas directas y rápidas
En una base clave-valor, cada registro se recupera a partir de una clave única, como el identificador de una sesión o el código de un elemento en una caché. Es un modelo sencillo y eficaz cuando la aplicación conoce la clave y no necesita hacer búsquedas complejas sobre los valores.
Puede encajar en sesiones, carritos temporales, preferencias o datos de acceso frecuente. No suele ser la opción indicada si se necesitan informes exploratorios o filtros variados sobre atributos que no forman parte de la clave.
Familias de columnas para grandes flujos distribuidos
Las bases orientadas a columnas amplias agrupan valores según claves y familias de columnas, y están pensadas para distribuir grandes cantidades de escrituras y lecturas entre varios nodos. Pueden ser apropiadas para telemetría, eventos o series de actividad, siempre que el patrón de consulta se conozca de antemano.
Su diseño suele premiar consultas concretas y predecibles. Si se intenta utilizarlas como una base relacional de propósito general, pueden aparecer consultas difíciles, duplicación innecesaria o una estructura poco clara para el equipo.
Grafos para relaciones que son el centro del problema
Una base de grafos representa entidades como nodos y sus vínculos como relaciones. Es útil cuando la pregunta principal consiste en recorrer conexiones: detectar rutas, sugerir contactos, analizar dependencias o relacionar productos con usuarios y categorías.
Si las relaciones son secundarias y predominan búsquedas sencillas por identificador, un grafo podría añadir una capa que no aporta valor. Lo conveniente es reservarlo para casos donde explorar vínculos sea una operación central y frecuente.
Un caso práctico: una plataforma de comercio electrónico
Imaginemos una tienda que vende ropa, dispositivos electrónicos y muebles. Cada familia de productos necesita atributos distintos: una talla y un material para una prenda, capacidad y conectividad para un dispositivo, medidas y acabado para un mueble. En una base documental, cada producto puede guardar sus datos específicos y la aplicación puede leer en una sola operación la información necesaria para mostrar la ficha.
Sin embargo, el pedido no es solo una lista de productos. Debe asociarse a un cliente, conservar el precio aplicado en el momento de la compra y mantener coherencia entre el pago, el inventario y el estado del envío. Si el sistema actualiza esos elementos como una única operación de negocio, las transacciones y restricciones de una base relacional pueden ofrecer una forma más sencilla de proteger la integridad.
La respuesta no tiene por qué ser elegir una sola tecnología para todo. Una arquitectura puede mantener pedidos y pagos en una base relacional, usar una base documental para el catálogo y una solución clave-valor para sesiones o caché. Ese enfoque, a veces llamado persistencia políglota, permite ajustar cada almacén a su tarea, pero añade trabajo operativo: copias de seguridad, monitorización, permisos, integración y conocimientos para cada sistema.
En una empresa pequeña, empezar con varios motores puede distraer al equipo del producto. Si una base relacional cubre las necesidades actuales y el catálogo no presenta problemas de rendimiento o evolución, es razonable mantener una arquitectura más simple. La especialización debería responder a una limitación comprobada o a un requisito claro, no a una previsión vaga de crecimiento.
Consistencia, escalado y costes que conviene revisar
Al evaluar bases de datos no relacionales, suele hablarse de escalabilidad horizontal: repartir datos y carga entre varios servidores. Puede ser útil para sistemas que crecen mucho o deben atender tráfico distribuido. No obstante, añadir nodos no resuelve por sí solo un modelo de datos deficiente, una consulta mal diseñada o índices que consumen demasiados recursos.
También hay que distinguir entre disponibilidad y consistencia. Algunos sistemas distribuidos permiten ajustar cuánto se replica y qué garantías ofrece una lectura. En determinadas configuraciones, una lectura puede devolver un cambio con retraso respecto de otra réplica. Eso puede ser aceptable para un contador de visitas, pero no necesariamente para una operación de inventario o una autorización de pago.
La pregunta útil no es si un motor es “consistente” en términos absolutos, sino qué garantía ofrece en cada operación y qué efecto tendría ver un dato desactualizado. Para un panel de métricas quizá sea tolerable; para confirmar una compra, puede causar ventas por encima del stock disponible. Hay que validar el comportamiento con pruebas que reproduzcan fallos de red, concurrencia y recuperación.
El coste tampoco se limita a la licencia o al servicio gestionado. Incluye almacenamiento de réplicas, transferencia de datos, índices, copias de seguridad, observabilidad y tiempo de administración. En un servicio cloud, revisar los patrones de lectura y escritura ayuda a evitar sorpresas: una consulta que parece pequeña puede resultar cara si escanea muchos registros o se ejecuta miles de veces por minuto.
Errores de diseño y una ruta de adopción sensata
- Elegir por popularidad: que una tecnología aparezca en muchas ofertas de empleo no demuestra que encaje con el dominio. Define primero las consultas críticas y las garantías que debe cumplir cada operación.
- Copiar el esquema relacional sin revisarlo: dividir cada dato en entidades y reconstruirlo con múltiples lecturas puede desaprovechar un modelo documental. Diseña alrededor de las operaciones reales, sin duplicar información de manera indiscriminada.
- Suponer que un esquema flexible significa ausencia de reglas: valida tipos, campos obligatorios y formatos en la aplicación o mediante las funciones del motor. La flexibilidad sin validación suele convertir los errores en trabajo de limpieza.
- Posponer la estrategia de índices: los índices aceleran ciertas consultas, pero consumen espacio y pueden ralentizar escrituras. Mide el efecto de cada uno y elimina los que no sirven a necesidades reales.
- Migrar antes de medir: registra latencia, volumen, coste y errores en el sistema existente. Si el problema no está identificado, cambiar de motor puede trasladarlo en vez de resolverlo.
Una adopción prudente puede empezar con una prueba acotada. Selecciona un flujo con límites claros, como el almacenamiento de sesiones o un catálogo con atributos variables. Define qué medir: tiempo de respuesta, tasa de errores, coste por operación, esfuerzo de desarrollo y comportamiento ante caídas. Ejecuta pruebas con datos representativos y carga similar a la esperada, no solo con unos pocos registros de demostración.
Después, revisa cómo se hacen las copias de seguridad y las restauraciones, quién administra las credenciales y qué pasos requiere una actualización. Una copia que nunca se ha restaurado no demuestra que el sistema pueda recuperarse. Para servicios críticos, las pruebas de recuperación y los objetivos de pérdida de datos y tiempo de interrupción deben formar parte del diseño.
Las bases de datos no relacionales son especialmente valiosas cuando el modelo de almacenamiento coincide con una necesidad concreta: datos flexibles, acceso por clave, escritura distribuida o relaciones complejas. Si predominan las transacciones entre entidades y las consultas ad hoc, una base relacional puede seguir siendo la alternativa más clara. La decisión accionable consiste en documentar las consultas, garantías y costes esperados, probar el motor con un caso real y ampliar su uso solo cuando los resultados justifiquen la complejidad añadida.