GLM-5.1 irrumpe en la carrera global y presume de superar a GPT-5.4 y Opus 4.6 en programación

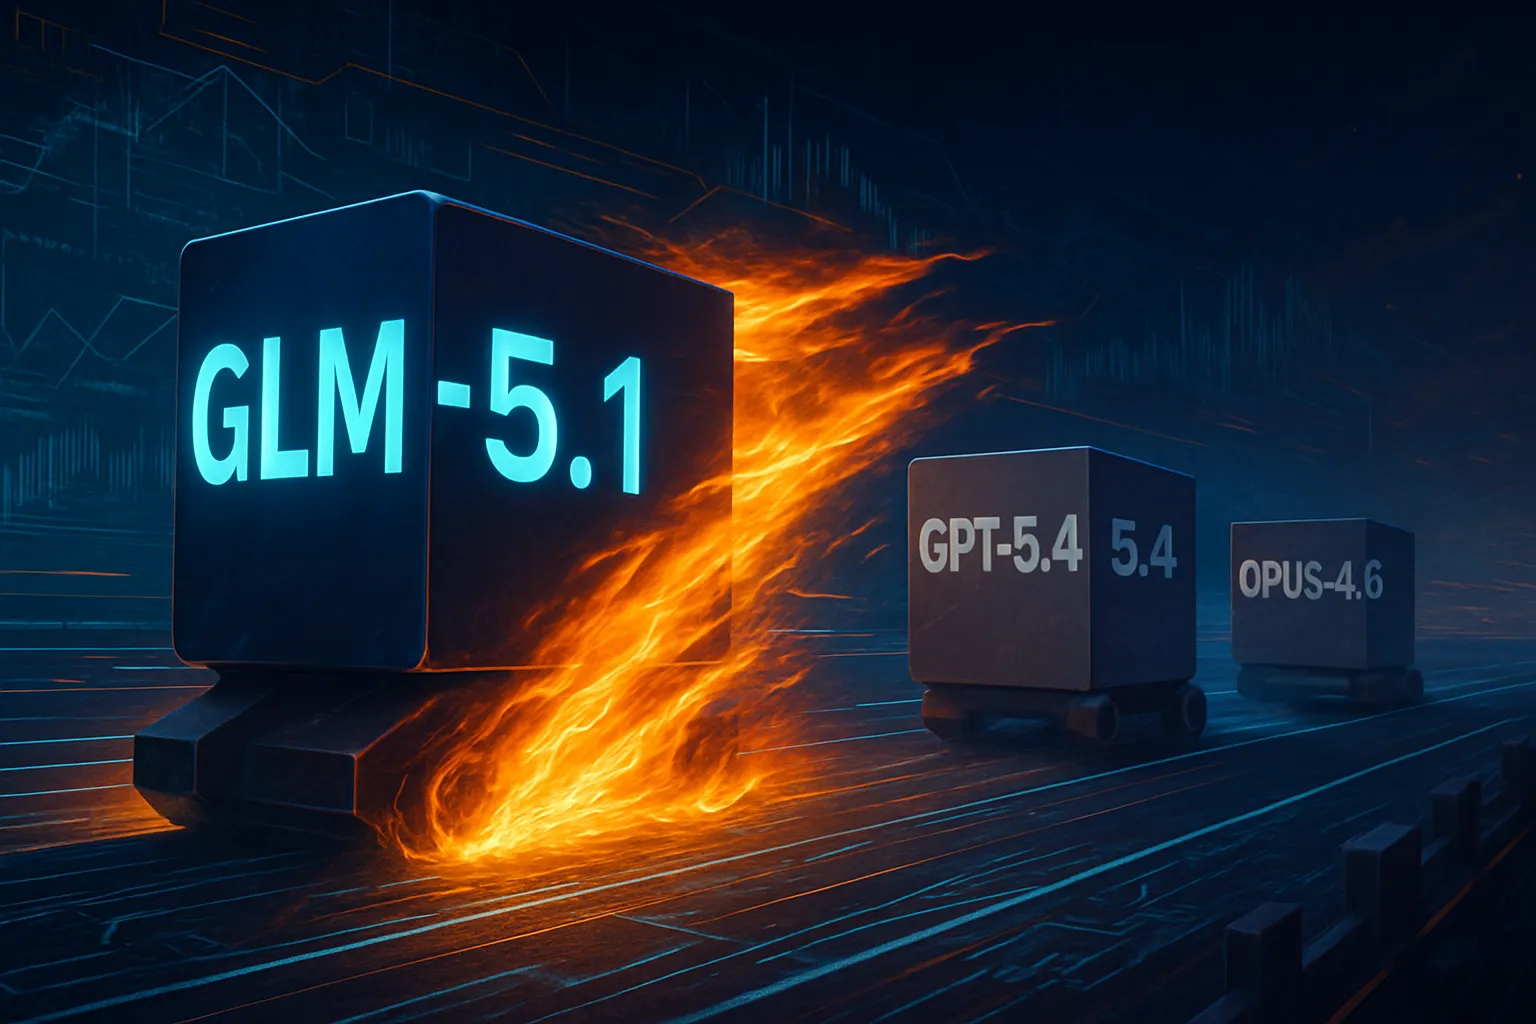
Una nueva versión de modelo de lenguaje ha entrado en el debate público sobre capacidades de programación. GLM-5.1 presume de superar a GPT-5.4 y Opus 4.6 en tareas relacionadas con generación y corrección de código. La afirmación abre preguntas técnicas y comerciales sobre qué significa avanzar en este campo y cómo se mide ese progreso.
Qué dice la afirmación y por qué genera expectación
El anuncio oficial evita cifras concretas. Se destaca que GLM-5.1 rinde mejor en escenarios de programación. Ese mensaje busca posicionar al modelo como alternativa para desarrolladores y empresas. En este contexto, la palabra clave es especialización: modelos diseñados para código compiten en métricas que valoran sintaxis, coherencia y eficiencia de ejecución.
La expectación se explica por la importancia del código en productos digitales. Mejoras en generación de código afectan flujos de trabajo, herramientas de desarrollo y potencialmente costos. Por eso cualquier reclamación robusta genera atención en la comunidad técnica y en responsables de producto.
Aspectos tecnológicos clave
Detrás de cualquier avance en programación hay varias capas tecnológicas. Tres elementos suelen marcar la diferencia: arquitectura del modelo, datos de entrenamiento y técnicas de evaluación. Cada uno influye en la capacidad de producir código correcto y útil.
Arquitectura y capacidad de cómputo
La arquitectura define cómo se representan y procesan patrones sintácticos y semánticos. Modelos orientados a código suelen incorporar mecanismos para entender estructuras de programas, dependencias entre archivos y convenciones de nombres. Además, la capacidad de cómputo disponible durante entrenamiento y afinamiento condiciona el grado de generalización.
Calidad y curación de datos
El corpus de entrenamiento es determinante. Un modelo entrenado con repositorios bien etiquetados, ejemplos de pruebas unitarias y correcciones reales está mejor preparado para generar código funcional. La curación incluye filtrar ejemplos repetidos, equilibrar lenguajes y aportar contextos de uso reales.
Estrategias de afinamiento para tareas de programación
El afinamiento con ejemplares de programación, correcciones y retroalimentación basada en ejecución reduce errores comunes. También se aplican técnicas como el aprendizaje por refuerzo con evaluación automática sobre pruebas de ejecución. Estas prácticas buscan mejorar la precisión sin sacrificar la versatilidad general del modelo.
Evaluación y límites de las comparaciones
Comparar modelos en programación exige cuidado. Las métricas tradicionales valoran precisión sintáctica, coincidencia con soluciones de referencia y éxito en pruebas de ejecución. Sin embargo, ninguna métrica captura por completo la utilidad real en proyectos complejos.
Un modelo puede sobresalir en tareas de completado de funciones cortas pero fallar en integración de sistemas o en mantenimiento de código largo. Además, la dependencia de prompts y del contexto que se entrega al modelo puede cambiar el resultado de forma notable.
Implicaciones para empresas y desarrolladores
Si GLM-5.1 demuestra ventajas prácticas, su impacto puede extenderse a herramientas de desarrollo, servicios de soporte y procesos de entrega de software. Las empresas podrían considerar su uso para acelerar prototipos, automatizar pruebas o asistir en revisiones de código.
No obstante, la adopción exige evaluación propia. Integrar un modelo en un flujo de trabajo implica verificar estabilidad, seguridad y compatibilidad con licencias de código. También es necesario valorar el coste y la capacidad del equipo para supervisar salidas y corregir errores.
Riesgos, consideraciones éticas y de seguridad
La generación automática de código plantea riesgos técnicos y éticos. Entre ellos están la posible introducción de vulnerabilidades, la reproducción de patrones inseguros y la dependencia excesiva en soluciones automatizadas. Por eso la supervisión humana y la integración de pruebas automatizadas son prácticas recomendadas.
Además, la procedencia de los datos de entrenamiento y las licencias asociadas afectan la viabilidad comercial. Las organizaciones deben comprobar que el uso del modelo no contraviene acuerdos de licencia ni expone a reclamaciones por propiedad intelectual.
Perspectiva de adopción y pasos siguientes
La transición de una versión prometedora a una adopción más amplia requiere pasos concretos. Primero, realizar pruebas controladas con casos de uso representativos. Segundo, medir no solo la calidad del código generado, sino su mantenibilidad y seguridad. Tercero, diseñar mecanismos de auditoría que detecten patrones problemáticos antes de que lleguen a producción.
En paralelo, los equipos técnicos deben planificar la integración con sistemas de CI/CD, establecer políticas de revisión humana y definir umbrales de confianza para automatizar tareas. Estas medidas reducen riesgos y permiten explotar beneficios sin comprometer la calidad del producto.
Ejemplo de evaluación práctica
Una evaluación práctica podría combinar tareas de generación con pruebas de ejecución. Se asignan escenarios concretos, se solicita al modelo generar soluciones y se ejecutan suites de pruebas para validar resultados. Este enfoque proporciona una visión funcional más útil que métricas sintácticas aisladas.
Consideraciones económicas
El costo total de propiedad incluye licencias, consumo de cómputo y recursos humanos para integración y supervisión. Las empresas deben comparar estos costes frente a la productividad añadida y al ahorro en tareas repetitivas. En algunos casos, la mejora en velocidad de entrega puede justificar la inversión; en otros, la complejidad de integración puede diluir ganancias.
Limitaciones técnicas a vigilar
Las limitaciones habituales incluyen alucinaciones en código, dependencia de contexto extenso para soluciones complejas y rendimiento variable entre lenguajes. También existen limitaciones en la comprensión de requisitos no formales, que todavía requieren interpretación humana.
La afirmación de que GLM-5.1 supera a otros modelos en programación debe leerse como una invitación a la verificación práctica. Las declaraciones generan interés, pero la decisión de adopción depende de pruebas propias y de la evaluación de riesgos. En todos los casos, la presencia de alternativas competitivas impulsa mejoras y obliga a proveedores y usuarios a definir criterios claros de evaluación.
En conclusión, la irrupción de un competidor con pretensiones de superioridad técnica pone en foco la necesidad de metodologías robustas para comparar modelos. Las diferencias técnicas pueden ser relevantes, pero su traducción a valor real exige pruebas, controles y una visión pragmática de integración en entornos de desarrollo.