JOIN en SQL: cómo combinar tablas sin perder ni duplicar filas

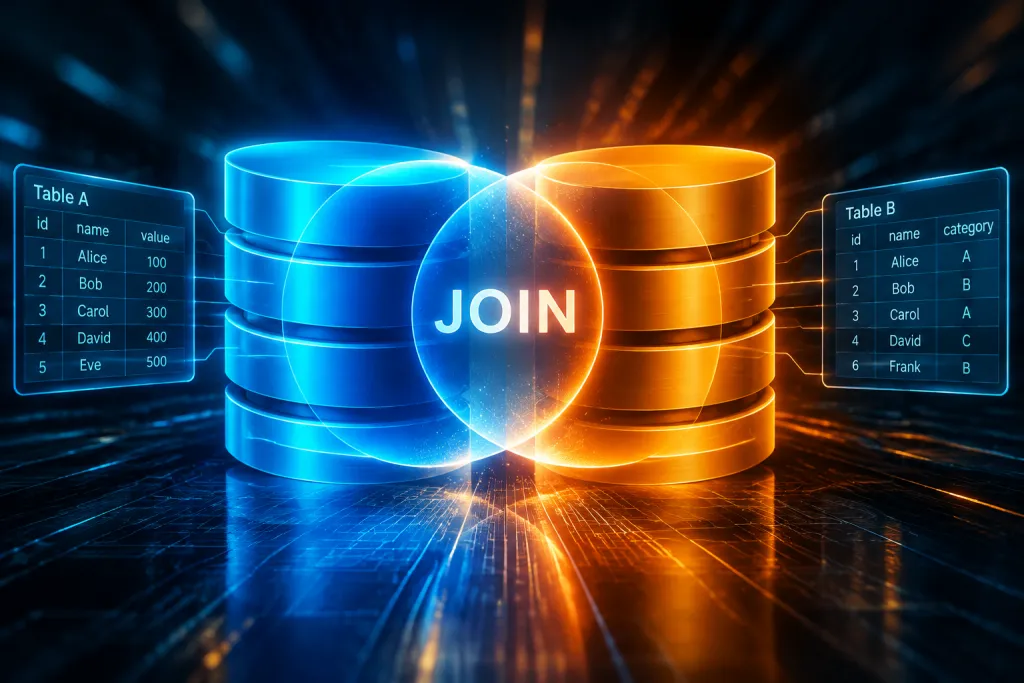
JOIN combina filas de dos o más tablas mediante una condición, normalmente una relación entre claves. La elección del tipo de unión determina qué registros aparecen cuando existe una coincidencia y qué ocurre cuando no la hay. Antes de escribirla, identifica qué representa cada tabla, qué columnas las relacionan y si necesitas conservar también las filas sin correspondencia.
Los ejemplos de este artículo son hipotéticos y usan dos tablas: clientes, con una fila por cliente, y pedidos, con una fila por pedido. La columna clientes.id identifica a cada cliente y pedidos.cliente_id indica quién realizó cada pedido.
Qué hace un JOIN y cómo encuentra las coincidencias
Una unión compara filas según la condición escrita después de ON. En este ejemplo, la relación es entre el identificador del cliente y el identificador guardado en el pedido:
SELECT clientes.nombre, pedidos.id AS pedido_id
FROM clientes
JOIN pedidos
  ON clientes.id = pedidos.cliente_id;
En SQL, JOIN sin una palabra adicional suele equivaler a INNER JOIN. El resultado incluye las parejas de filas que cumplen la condición. Si un cliente tiene tres pedidos, su nombre aparecerá tres veces: una por cada pedido. No es necesariamente un duplicado erróneo; es la consecuencia de relacionar una fila de cliente con varias filas de pedido.
La columna empleada para unir no tiene que llamarse igual en ambas tablas, aunque es habitual que una tabla use una clave primaria y la otra una clave foránea. Una clave primaria identifica una fila de forma única; una clave foránea guarda una referencia a otra tabla. Si la relación no está definida así, la condición debe reflejar igualmente el criterio real de correspondencia.
INNER y LEFT: la diferencia que cambia qué registros sobreviven
INNER JOIN devuelve solo coincidencias
INNER JOIN excluye los clientes que no tienen pedidos y también los pedidos cuyo cliente_id no encuentra una fila correspondiente en clientes. Es adecuado para consultas que requieren datos presentes en ambos lados, como una lista de pedidos con el nombre del cliente asociado.
LEFT JOIN conserva todas las filas de la tabla izquierda
LEFT JOIN conserva cada fila de la tabla situada antes de la unión. Cuando no encuentra una coincidencia, las columnas de la tabla derecha aparecen como NULL:
SELECT clientes.id, clientes.nombre, pedidos.id AS pedido_id
FROM clientes
LEFT JOIN pedidos
  ON clientes.id = pedidos.cliente_id;
Esta variante permite, por ejemplo, listar todos los clientes aunque todavía no hayan comprado. Un cliente sin pedidos aparecerá una vez con pedido_id igual a NULL; otro con varios pedidos aparecerá en varias filas.
RIGHT JOIN conserva las filas de la tabla derecha. Puede expresar consultas válidas, pero a menudo resulta más fácil de leer intercambiar el orden de las tablas y usar LEFT JOIN. FULL OUTER JOIN conserva las filas de ambos lados, con NULL donde falte una correspondencia; su disponibilidad y sintaxis dependen del sistema de bases de datos utilizado.
ON y WHERE no son intercambiables en todas las consultas
ON especifica cómo se relacionan las tablas. WHERE filtra las filas del resultado. La diferencia se nota especialmente con una unión externa, como LEFT JOIN.
Supongamos que se quieren mostrar todos los clientes y, si existen, solo sus pedidos con estado «enviado». Esta consulta conserva a quienes no tienen ningún pedido enviado:
SELECT clientes.nombre, pedidos.id AS pedido_id
FROM clientes
LEFT JOIN pedidos
  ON clientes.id = pedidos.cliente_id
 AND pedidos.estado = 'enviado';
En cambio, si se coloca pedidos.estado = 'enviado' en el WHERE, las filas sin pedido tienen pedidos.estado igual a NULL y no superan ese filtro. El resultado deja de conservar a esos clientes, por lo que en la práctica se comporta como una selección de coincidencias con pedido enviado. Para decidir dónde va un filtro, pregunta si debe restringir las coincidencias de la unión o eliminar filas del resultado final.
Por qué una unión puede multiplicar filas
El número de filas resultante depende de la cardinalidad de la relación: cuántas filas de una tabla pueden corresponder a cada fila de la otra. En una relación uno a muchos, como cliente a pedidos, una fila del cliente se repite por cada pedido. En una relación muchos a muchos, una unión directa puede generar muchas combinaciones.
Un ejemplo habitual de relación muchos a muchos sería productos y categorías: un producto puede pertenecer a varias categorías y una categoría contener varios productos. Una tabla intermedia, como producto_categoria, guarda cada asociación. Para obtener los nombres de las categorías de cada producto, se unen las tres tablas siguiendo esas relaciones. Si se omite una condición o se enlazan columnas inadecuadas, pueden aparecer combinaciones no deseadas o un resultado mucho mayor de lo esperado.
Cuando una consulta debería producir una fila por cliente, revisa si la tabla unida contiene varias filas por cliente. Si las contiene, decide si realmente necesitas todas, una agregación como COUNT o SUM, o una selección previa de un único registro. Añadir DISTINCT puede ocultar repeticiones idénticas, pero no corrige una condición de unión equivocada ni explica por qué se repite la información.
Cómo localizar filas sin correspondencia
Una combinación de LEFT JOIN y una comprobación de IS NULL encuentra filas de la tabla izquierda que no tienen pareja en la derecha:
SELECT clientes.id, clientes.nombre
FROM clientes
LEFT JOIN pedidos
  ON clientes.id = pedidos.cliente_id
WHERE pedidos.id IS NULL;
Este patrón puede servir para identificar clientes sin pedidos. La columna comprobada debe pertenecer a la tabla derecha y ser una columna que necesariamente tenga valor en las filas reales, como su clave primaria. No uses = NULL: en SQL, los valores nulos se comprueban con IS NULL o IS NOT NULL.
Un método práctico para construir y comprobar la consulta
- Define el resultado esperado. Especifica si necesitas solo coincidencias, todas las filas de una tabla o también registros sin pareja.
- Identifica las claves de relación. Comprueba qué columnas vinculan realmente las tablas y si la relación es uno a uno, uno a muchos o muchos a muchos.
- Escribe primero una unión sencilla. Selecciona las claves de ambas tablas junto con las columnas necesarias; añade después los filtros.
- Comprueba las filas sin coincidencia. Un
LEFT JOINcon una clave de la tabla derecha aNULLayuda a ver qué registros quedarían fuera con unINNER JOIN. - Compara el recuento con lo esperado. Si hay más filas de las previstas, revisa las relaciones uno a muchos, las claves repetidas y las condiciones incompletas.
Si varias tablas tienen columnas con el mismo nombre, usa el nombre de tabla o un alias para evitar ambigüedades: por ejemplo, c.nombre y p.id, tras asignar clientes c y pedidos p. Esta práctica también facilita leer consultas con varias uniones. Para ampliar conceptos relacionados con el diseño y las consultas, puedes consultar la sección de Bases de Datos.
Por último, CROSS JOIN genera todas las combinaciones posibles entre las filas de ambas tablas. Solo es apropiado cuando se busca deliberadamente ese producto cartesiano —por ejemplo, todas las combinaciones de tallas y colores—; aplicado por accidente, puede disparar el número de filas. La regla práctica es comprobar siempre que cada unión expresa una relación concreta y que el tipo elegido conserva exactamente los registros que necesita el análisis.