Nvidia prepara un sistema de 576 GPU Rubin Ultra conectadas mediante fibra óptica

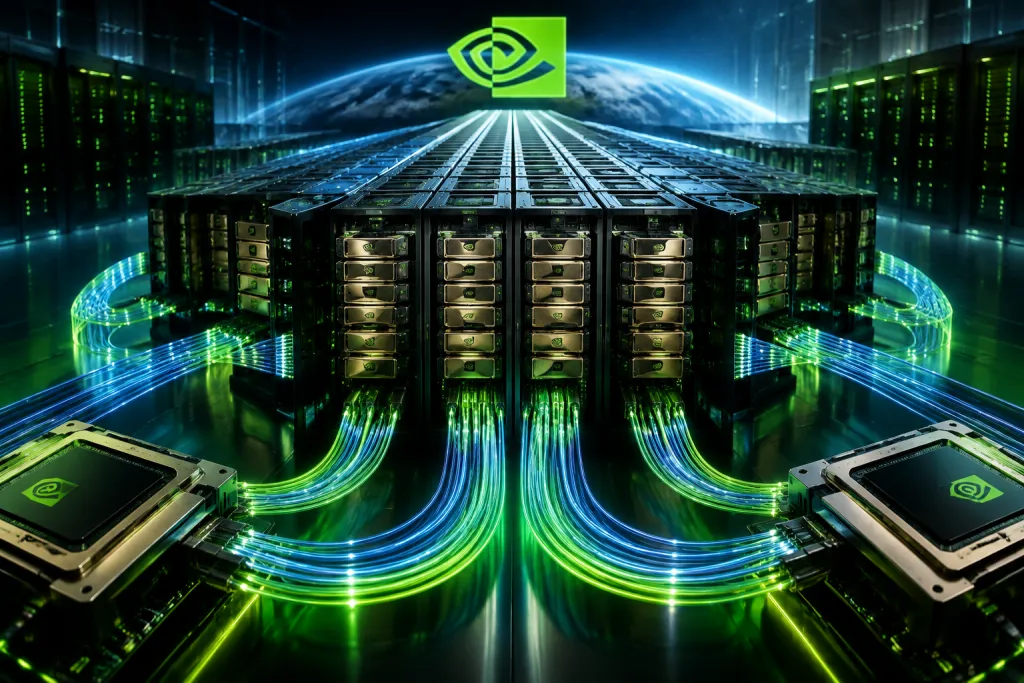
Nvidia prepara un sistema de computación con 576 GPU Rubin Ultra conectadas mediante fibra óptica, una propuesta que apunta a una nueva escala para la inteligencia artificial y la computación de alto rendimiento. La cifra no describe un ordenador convencional, sino una infraestructura formada por numerosos aceleradores que deben trabajar de manera coordinada. El diseño pone el foco tanto en la potencia de cálculo como en el movimiento de datos entre sus componentes: cuando cientos de GPU colaboran, la conexión que las une puede ser tan decisiva como los propios chips.
La fibra óptica permite transportar información mediante señales luminosas y ofrece ventajas para comunicar equipos separados dentro de una instalación. Su presencia en esta arquitectura refleja un reto central de los centros de datos: aumentar la capacidad de procesamiento sin que las comunicaciones internas se conviertan en un cuello de botella. El sistema Rubin Ultra, por tanto, no se entiende solo como una colección de GPU más potentes. También plantea cómo organizar, conectar y alimentar una infraestructura de gran tamaño.
Por qué reunir cientos de GPU en un mismo sistema
Los modelos de inteligencia artificial de gran escala requieren realizar una enorme cantidad de operaciones y manejar conjuntos de datos voluminosos. Una sola GPU puede ejecutar numerosas tareas en paralelo, pero hay cargas de trabajo que superan la capacidad de un dispositivo individual. En esos casos, el trabajo se reparte entre varios aceleradores para procesar partes de un modelo o de un conjunto de datos al mismo tiempo.
La coordinación resulta esencial. Los aceleradores deben intercambiar parámetros, resultados parciales y otra información necesaria para completar una tarea. Si la comunicación entre ellos es lenta o irregular, parte de la capacidad de cálculo queda desaprovechada mientras los dispositivos esperan datos. Por eso, una máquina con cientos de GPU necesita una red interna diseñada para sostener flujos de información intensos y continuos.
El planteamiento de 576 GPU apunta a una plataforma concebida para cargas de trabajo que requieren más capacidad conjunta que la que puede ofrecer un servidor individual. Esa escala puede servir para entrenar modelos, ejecutar simulaciones complejas o atender procesos de inferencia de gran volumen. La utilidad concreta dependerá de la configuración del sistema, del software disponible y de la naturaleza de cada tarea; el número de aceleradores, por sí solo, no garantiza un rendimiento proporcional.
La fibra óptica como pieza de la arquitectura
En una infraestructura de estas dimensiones, las conexiones eléctricas tradicionales afrontan límites relacionados con la distancia, la señal y el consumo. La fibra óptica transporta datos con luz por un medio físico y puede cubrir enlaces de alta capacidad entre equipos. Esto permite diseñar redes internas capaces de conectar componentes distribuidos en una instalación, aunque la fibra no elimina por sí misma todos los problemas de comunicación ni sustituye la necesidad de una arquitectura de red eficiente.
El valor de la conexión depende de varios elementos. Importan la velocidad de transmisión, la latencia, la cantidad de enlaces disponibles y la forma en que se organizan las rutas de datos. También cuenta el diseño de los sistemas que convierten las señales eléctricas de los equipos en señales ópticas y viceversa. Cada conversión y cada salto pueden influir en el comportamiento global, de modo que la integración entre GPU, red y software debe planificarse como un conjunto.
La fibra también puede facilitar conexiones entre partes de un sistema que no se encuentran en una única placa o chasis. En lugar de concentrar todos los componentes en un espacio reducido, una instalación puede distribuirlos y conectarlos mediante enlaces ópticos. Esa flexibilidad resulta relevante para escalar centros de datos, aunque exige una gestión cuidadosa del cableado, la refrigeración, la alimentación eléctrica y el mantenimiento.
Menos distancia no siempre significa menos latencia
La velocidad de propagación de la luz es alta, pero el rendimiento de una red no depende únicamente del medio físico. Los equipos de conmutación, los protocolos, la congestión y la cantidad de pasos que debe recorrer cada mensaje también tienen un papel importante. Una red bien diseñada debe reducir las esperas y asegurar que las GPU reciban los datos que necesitan en el orden y el momento adecuados.
Por ese motivo, la fibra óptica debe entenderse como una herramienta de conectividad, no como una solución automática. El sistema necesita combinar enlaces adecuados con una topología que evite concentrar demasiado tráfico en pocos puntos. En tareas de inteligencia artificial, donde los aceleradores intercambian información con frecuencia, un diseño equilibrado puede influir directamente en cuánto tiempo permanecen ocupados los procesadores.
El rendimiento depende del conjunto
Una cifra de 576 GPU ofrece una referencia sobre la escala, pero no permite deducir por sí sola la velocidad de una aplicación. El resultado depende de la capacidad de cada acelerador, de la memoria disponible, del ancho de banda entre componentes y de la eficiencia con que el software distribuya el trabajo. También influye el tipo de operación: entrenar un modelo, generar respuestas o ejecutar una simulación puede imponer necesidades distintas.
La memoria es uno de los factores que condicionan el tamaño de los modelos y el volumen de datos que se procesa en paralelo. Si una carga de trabajo requiere mover información de forma constante entre la memoria y las unidades de cálculo, una red rápida no resolverá todos los límites. La arquitectura debe equilibrar capacidad de cómputo, almacenamiento, memoria y comunicaciones para evitar que un componente frene al resto.
El software cumple una función igual de relevante. Los sistemas de programación deben dividir las operaciones, distribuirlas entre las GPU y coordinar los resultados. También tienen que gestionar fallos y mantener el uso de los recursos con eficiencia. Una infraestructura de gran escala puede ofrecer mucha capacidad teórica, pero aprovecharla requiere herramientas compatibles y modelos preparados para ejecutarse de forma paralela.
Retos de energía, refrigeración y operación
Concentrar cientos de aceleradores implica atender necesidades físicas que van más allá del diseño de la red. Las GPU consumen energía y generan calor durante el procesamiento. Por eso, la alimentación eléctrica y la refrigeración forman parte de la planificación desde el inicio. Una instalación que no pueda suministrar energía de manera estable o evacuar el calor tendrá dificultades para mantener el funcionamiento previsto.
La refrigeración puede recurrir a distintas soluciones, y la elección depende de la densidad de los equipos, las condiciones del centro de datos y los objetivos de operación. El reto consiste en controlar la temperatura sin desperdiciar recursos y sin comprometer la disponibilidad. A ello se suman las tareas de supervisión, mantenimiento y sustitución de componentes, que se vuelven más complejas cuando la infraestructura reúne tantos elementos interconectados.
Entre los aspectos que deben resolverse para desplegar un sistema de esta escala figuran:
- Garantizar una red interna capaz de transportar datos sin crear congestiones persistentes.
- Coordinar el consumo eléctrico y la refrigeración con la densidad de los aceleradores.
- Distribuir las cargas de trabajo para mantener ocupadas las GPU y reducir tiempos de espera.
- Proteger la disponibilidad del conjunto frente a fallos de componentes o interrupciones de servicio.
- Integrar la infraestructura con los sistemas de almacenamiento y las herramientas de software necesarias.
Estos factores también tienen una dimensión económica. Una instalación de alta densidad exige inversión en aceleradores, redes, energía, espacio y operación especializada. Las organizaciones que evalúen una plataforma de este tipo deberán comparar ese coste con la capacidad que necesitan y con el valor de las tareas que pretenden ejecutar. Para algunas cargas, una gran agrupación de GPU puede resultar adecuada; para otras, una infraestructura menor o distribuida puede ser más eficiente.
Una señal sobre el rumbo de los centros de datos
La propuesta de Rubin Ultra muestra que la evolución de la computación para inteligencia artificial no se limita a fabricar chips con más capacidad. El diseño de sistemas completos cobra protagonismo: los aceleradores, las redes ópticas, la memoria, la energía y el software tienen que funcionar de manera coordinada. El rendimiento final depende de cómo se integran esas piezas y de si el centro de datos puede sostenerlas.
También refleja un cambio en la forma de pensar la escala. En lugar de considerar cada servidor como una unidad aislada, las arquitecturas actuales se diseñan como grupos de recursos que colaboran. La conexión mediante fibra óptica puede ayudar a enlazar esos recursos y a ampliar la infraestructura, pero el resultado dependerá de decisiones técnicas que no se reducen al número de GPU.
Para las empresas, la cuestión será determinar qué tareas justifican una plataforma de esta magnitud. El entrenamiento de modelos avanzados y ciertos procesos de simulación pueden beneficiarse de una capacidad de cálculo muy elevada, siempre que el movimiento de datos y el consumo estén bajo control. En cambio, las aplicaciones con cargas más modestas podrían no aprovechar toda la infraestructura disponible.
La preparación de un sistema con 576 GPU Rubin Ultra sitúa en primer plano una idea clave: la próxima escala de la inteligencia artificial exige diseñar tanto el cálculo como las comunicaciones. La fibra óptica aparece como una pieza de esa ecuación, junto con la memoria, la refrigeración y el software. Su impacto real no dependerá únicamente de conectar más aceleradores, sino de conseguir que todos trabajen como una unidad eficiente y operable.