¿Qué es el cloud híbrido con edge computing? Arquitectura y usos reales

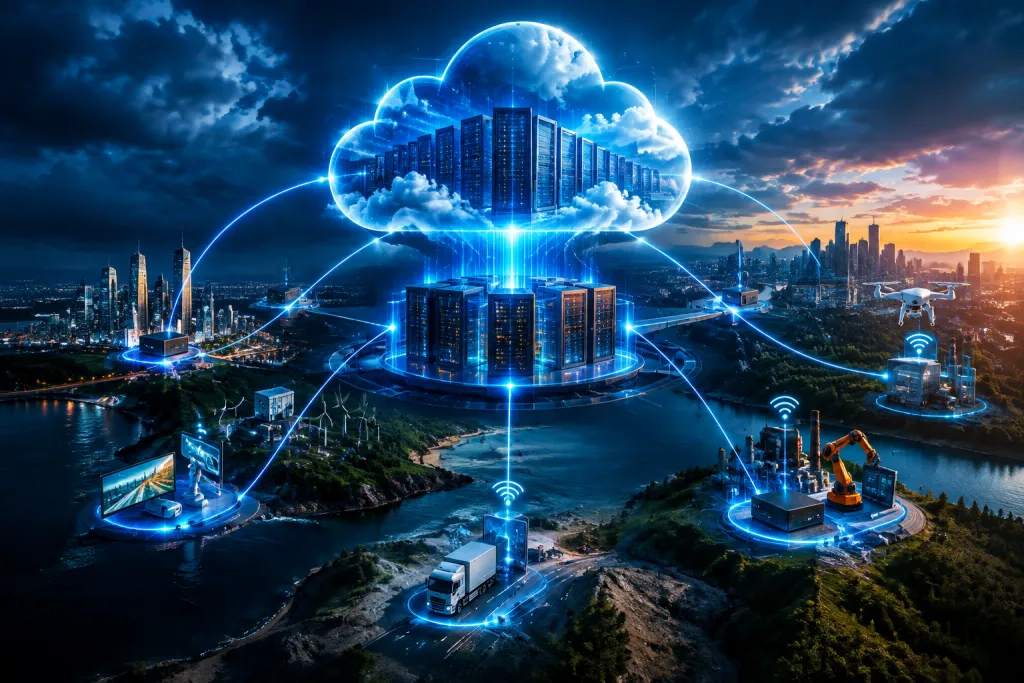
¿Qué es el cloud híbrido con edge computing? Es una arquitectura que combina infraestructura local o privada, servicios de nube pública y capacidad de procesamiento situada cerca de donde se generan los datos. En lugar de enviar toda la información a un centro de datos remoto, cada tarea se ejecuta en el lugar que mejor responde a sus requisitos de velocidad, seguridad, coste y disponibilidad. La combinación resulta útil cuando una empresa necesita conservar control sobre ciertos sistemas y, al mismo tiempo, reaccionar en milisegundos ante datos producidos en fábricas, tiendas, vehículos o dispositivos conectados.
Una arquitectura distribuida, no una nube más grande
El cloud híbrido conecta entornos diferentes bajo una estrategia común. Puede incluir centros de datos propios, nubes privadas, uno o varios proveedores de nube pública y servicios alojados en instalaciones externas. El edge computing añade nodos de cómputo en ubicaciones periféricas: por ejemplo, una pasarela industrial, un servidor en una sucursal o un equipo integrado en una máquina. Estos nodos procesan datos cerca de su origen, en vez de depender siempre de una conexión con la nube central.
La diferencia clave está en la distribución de responsabilidades. La nube suele aportar capacidad elástica, almacenamiento amplio y herramientas para analizar grandes volúmenes de información. El edge resuelve tareas sensibles a la latencia o que deben seguir funcionando aunque la conexión se interrumpa. El entorno local o privado puede alojar aplicaciones heredadas, datos sujetos a políticas internas o servicios que requieren control directo.
No se trata de duplicar todo en todas partes. Una arquitectura bien planteada asigna cada componente según sus necesidades. Si una cámara detecta una anomalía en una línea de producción, el análisis inicial puede ocurrir en la fábrica y activar una parada inmediata. Después, los datos relevantes pueden enviarse a la nube para comparar patrones entre plantas, entrenar modelos o elaborar informes. Así, la decisión urgente no depende de la latencia de una conexión remota, mientras el análisis estratégico aprovecha recursos centralizados.
Cómo viajan los datos y dónde se ejecuta cada tarea
El recorrido suele comenzar en sensores, terminales, cámaras o aplicaciones. Un nodo edge recibe los datos, los filtra y ejecuta reglas locales. Puede descartar mediciones repetitivas, resumirlas o conservarlas durante un periodo definido. Luego, la información seleccionada se sincroniza con una plataforma central, donde se almacena, se combina con otras fuentes y se utiliza para análisis de mayor escala.
La sincronización no siempre es inmediata ni continua. En una ubicación con conectividad irregular, el nodo periférico puede operar en modo desconectado y poner en cola los datos hasta recuperar la conexión. Al restablecerse el enlace, debe resolver conflictos, evitar duplicados y aplicar políticas de retención. Ese comportamiento se diseña de antemano; no basta con instalar un servidor pequeño en cada sede y asumir que la operación será transparente.
Una división práctica puede verse en una cadena de frío. Los sensores de un almacén miden temperatura y humedad. El edge detecta desviaciones y envía una alerta al personal local sin esperar respuesta de la nube. La plataforma central conserva el historial de varios almacenes, identifica fallos recurrentes y ayuda a planificar mantenimiento. Los datos de telemetría detallados pueden conservarse poco tiempo, mientras que las alertas y los resúmenes se guardan durante más tiempo para auditoría y análisis.
La asignación depende también de la sensibilidad de la información. Un sistema puede mantener datos personales en una infraestructura controlada y remitir a la nube únicamente métricas agregadas. Sin embargo, procesar en el edge no elimina por sí solo las obligaciones de privacidad: el dispositivo periférico también requiere controles de acceso, cifrado, actualizaciones y protección física.
Cuándo aporta valor y cuándo añade complejidad
Esta combinación suele tener sentido si existe una necesidad concreta que la nube central por sí sola no resuelve bien. Entre los casos habituales se encuentran la automatización industrial, la inspección visual en tiempo real, los puntos de venta con conectividad limitada, la gestión de flotas, la monitorización de infraestructuras y las aplicaciones de salud que requieren respuesta local. En todos ellos, la latencia, la continuidad operativa o el volumen de datos pueden justificar el procesamiento distribuido.
- Respuesta rápida: una decisión se toma cerca de la máquina o del usuario, reduciendo la dependencia de la ida y vuelta a un centro de datos remoto.
- Menos tráfico de red: se pueden transmitir eventos, resultados o agregados, en vez de enviar cada señal sin filtrar.
- Continuidad local: ciertas funciones pueden mantenerse durante una caída del enlace, siempre que se hayan diseñado para operar sin servicios centrales.
- Control de datos: la empresa puede definir qué información permanece en cada instalación y cuál se comparte con servicios externos.
El modelo no siempre compensa. Una aplicación web convencional con pocos usuarios, datos centralizados y tolerancia a una latencia normal quizá funcione mejor en una nube pública bien configurada. Añadir nodos edge puede elevar los costes de hardware, soporte, observabilidad y seguridad. También crea más lugares que mantener, actualizar y supervisar. Si no hay una exigencia de tiempo real, conectividad intermitente, residencia de datos o reducción significativa del tráfico, una arquitectura más sencilla suele ser preferible.
Conviene evaluar el coste total, no solo el precio de las máquinas. Hay que incluir conectividad, licencias, repuestos, instalación en campo, gestión de versiones, respuesta ante incidentes y renovación del equipamiento. Una organización con decenas de sedes puede descubrir que el ahorro de ancho de banda queda superado por el esfuerzo de operar dispositivos heterogéneos. Una prueba acotada permite comprobarlo con métricas antes de ampliar el despliegue.
Decisiones de diseño que evitan problemas operativos
El primer paso es clasificar las cargas de trabajo. Para cada aplicación, conviene documentar cuánto tiempo puede esperar una respuesta, qué ocurre si se pierde la conexión, qué datos deben conservarse y qué sistemas tienen que comunicarse. Esa información ayuda a decidir si una tarea debe ejecutarse en el dispositivo, en un nodo edge, en un centro de datos propio o en la nube pública.
Después se definen los límites de autonomía. Una máquina puede necesitar detenerse de forma segura si no recibe una instrucción central, mientras que un sistema de inventario quizá pueda acumular cambios y sincronizarlos más tarde. En el diseño deben quedar claras las reglas para operar desconectado, los procedimientos de recuperación y la autoridad que prevalece si dos sistemas modifican el mismo dato.
La seguridad merece un diseño específico para la periferia. Los nodos están distribuidos y, en ocasiones, quedan en lugares con acceso físico menos controlado. Es recomendable utilizar identidades únicas para dispositivos, cifrado en tránsito y en reposo, arranque seguro cuando esté disponible, gestión centralizada de parches y registro de actividad. También hay que limitar los permisos: que un equipo procese datos localmente no significa que necesite acceso a toda la red corporativa.
La observabilidad debe abarcar nube, centro de datos y edge. Una consola centralizada ayuda a conocer versiones, estado de conectividad, uso de recursos y fallos, pero debe funcionar incluso cuando una sede no puede comunicarse. Las alertas locales y los registros almacenados temporalmente permiten investigar incidentes después de recuperar el enlace. Sin una estrategia de operación remota, el mantenimiento de cada instalación puede convertirse en una sucesión de visitas y diagnósticos manuales.
También conviene favorecer interfaces y formatos interoperables. Una arquitectura atada a un único proveedor o a equipos difíciles de reemplazar puede limitar futuras decisiones. Eso no obliga a evitar cualquier servicio propietario: puede ser razonable si aporta valor y el riesgo se acepta conscientemente. Lo importante es saber cómo migrar los datos, sustituir componentes y conservar la operación si una plataforma cambia sus condiciones.
Una implantación por fases: del piloto a la operación
Un piloto útil aborda un problema delimitado y medible, no intenta representar toda la estrategia tecnológica de la empresa. Por ejemplo, una planta puede probar detección local de vibraciones en una línea concreta. Antes de empezar, se fijan indicadores: tiempo de respuesta, porcentaje de datos enviados, duración de operación sin conexión, incidencias y coste de soporte. Después se compara el resultado con la solución actual, incluyendo el trabajo operativo que el piloto requiere.
Si la prueba demuestra valor, el siguiente paso es estandarizar. Definir modelos de dispositivo, configuraciones, mecanismos de actualización y políticas de seguridad reduce diferencias entre sedes. La expansión debería priorizar ubicaciones con condiciones parecidas y documentar las excepciones. Una fábrica con red estable y personal técnico no presenta los mismos requisitos que una estación remota sin soporte presencial.
En una empresa minorista, por ejemplo, los terminales de una tienda pueden mantener ventas y reglas básicas de inventario durante una interrupción de internet. Al volver la conexión, los movimientos se sincronizan con el sistema central. Para que el mecanismo sea fiable, hay que acordar qué pasa si una promoción cambia mientras la tienda está desconectada, cómo se reconcilian existencias y qué operaciones no se permiten sin validación. El valor no procede simplemente de instalar un nodo local, sino de resolver esas condiciones operativas.
La evaluación debe repetirse cuando cambien el volumen de datos, las aplicaciones o las obligaciones regulatorias. Una carga que hoy requiere procesamiento periférico puede trasladarse a la nube si mejora la conectividad o cambia el objetivo de latencia. También puede ocurrir lo contrario: una aplicación centralizada puede necesitar funciones locales cuando aparecen nuevas restricciones. La arquitectura híbrida funciona mejor como una distribución revisable de cargas, no como una decisión irreversible.
Una decisión basada en requisitos, no en etiquetas
El cloud híbrido con edge computing combina control, capacidad central y procesamiento cercano al origen, pero no es automáticamente más rápido, seguro o económico. Su valor depende de asignar cada tarea al entorno adecuado y de poder operar todos esos entornos como un sistema coherente. Las necesidades de latencia, continuidad, privacidad, conectividad y coste deben traducirse en requisitos verificables.
Antes de adoptarlo, identifica una carga de trabajo donde la distancia a la nube o la dependencia de la conexión cause un problema comprobable. Mide el rendimiento actual, prueba una solución localizada y calcula el coste completo de gestionarla. Si mejora una necesidad real y el equipo puede sostener la operación distribuida, el modelo ofrece una base flexible. Si no, mantener una arquitectura más simple será una decisión técnica igualmente válida.