¿Qué es ELT en la nube? Guía práctica para equipos de datos

El término ELT aparece en conversaciones de tecnología con tanta frecuencia que resulta fácil confundirlo con una moda pasajera. No lo es. ELT en la nube es una forma de mover y preparar datos que cambia decisiones operativas, reduce costes visibles y, sobre todo, permite experimentación más rápida. El texto explica qué es, cómo se monta en la práctica y qué errores evitar.
¿Qué significa ELT y por qué importa?
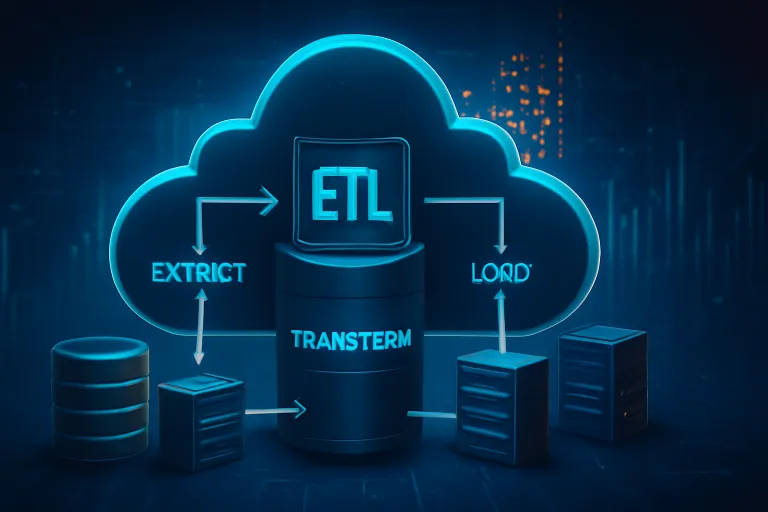
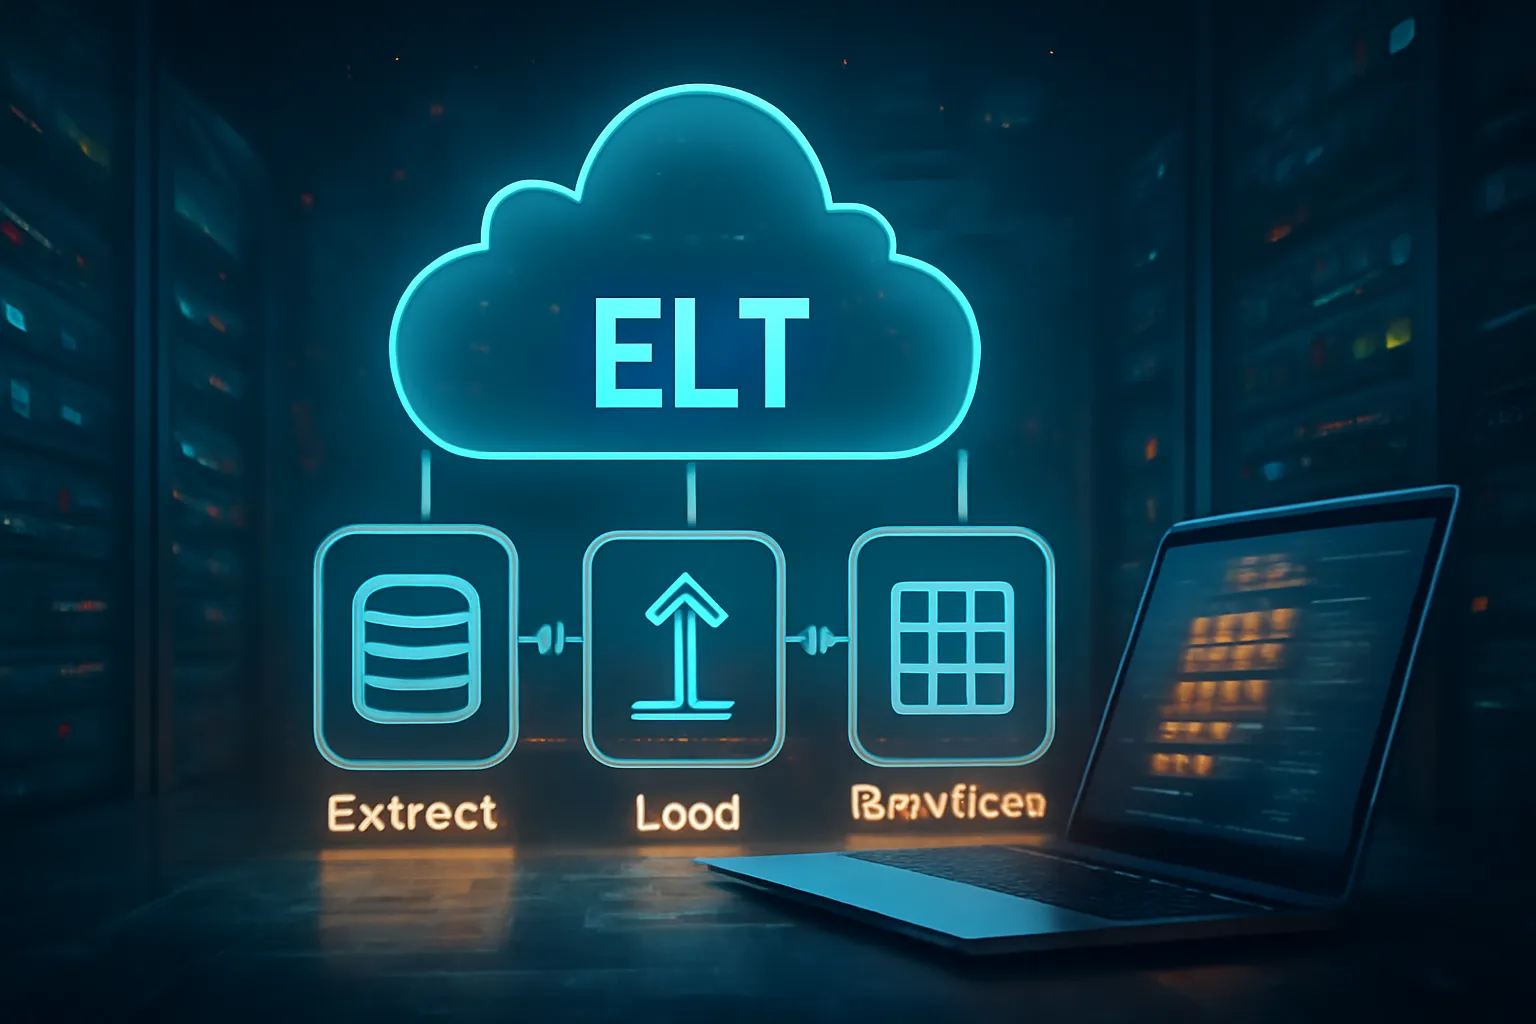
ELT es el flujo de trabajo que sigue tres pasos: Extraer datos de las fuentes, Cargar esos datos en un almacén escalable y Transformar dentro del propio almacén. Ese orden invierte la lógica clásica de ETL, donde la transformación ocurre antes de cargar.
Diferencia con ETL
La diferencia esencial está en el lugar donde ocurren las transformaciones. En ETL se transforma fuera del almacén y luego se carga. En ELT se aprovecha la potencia del almacén moderno para hacer transformaciones SQL o en proceso distribuido después de la carga. Eso permite: menores latencias en la ingestión, reuso de raw data y experimentación con nuevos modelos sin rehacer pipelines.
Por qué en la nube
La nube aporta dos piezas claves: escala elástica para procesamiento y almacenamiento persistente barato. En lugar de provisionar clústeres fijos, la nube permite ejecutar transformaciones intensas puntualmente y pagar sólo por ese uso. Además, los proveedores ofrecen servicios gestionados que reducen la carga operativa.
Arquitectura típica de ELT en la nube
Una arquitectura ELT real consta de componentes claros y sencillos de identificar en cualquier organización que trabaja con datos.
1. Fuentes de datos y extracción
Las fuentes pueden ser bases transaccionales, APIs, logs de aplicaciones o streams. La extracción prioriza consistencia y velocidad: se extrae en bruto (raw) con marcas de tiempo y metadatos que permitan reconstruir y auditar.
2. Carga al almacenamiento central
El destino suele ser un data warehouse o data lakehouse en la nube. En este paso se busca integridad y compresión: los datos se cargan tal cual y se etiqueta su procedencia. La carga debe ser tolerante a fallos y rastreable.
3. Transformación dentro del almacén
Las transformaciones se ejecutan con SQL, Spark o con motores nativos del proveedor. Aquí se construyen modelos analíticos, tablas limpias y vistas consumibles por BI o ML. Al mantener raw data, se facilita la corrección de errores y la creación de nuevas métricas sin rehacer la ingestión.
Ventajas y desventajas del ELT en la nube
Elegir ELT no es una panacea; conviene evaluar pros y contras en función del caso de uso y la madurez del equipo.
- Ventajas: rapidez de ingestión, reutilización de raw data, escalabilidad y menor necesidad de infraestructuras ETL on-premise.
- Desventajas: riesgo de convertir el almacén en un «cementerio» de datos si no hay gobernanza, posibles costes por consultas intensivas, y necesidad de control de acceso fino.
Herramientas y servicios populares en la nube
No todas las plataformas sirven para todos los casos. La elección depende de patrones de consulta, volumen y requisitos de gobernanza.
Comparación práctica
– Snowflake: destaca por separación entre almacenamiento y cómputo. Ideal para BI y cargas mixtas. Buena para equipos que quieren simplicidad operativa.
– BigQuery: potente para análisis a gran escala y con facturación por consulta. Útil cuando predominan consultas ad-hoc.
– Redshift: eficiente en AWS, mejora con RA3 y almacenamiento gestionado; tiene buen rendimiento para cargas tradicionales.
– Databricks: enfoque lakehouse con fuerte capacidad en ETL/ELT y ML; adecuado para pipelines complejos y data science.
Mini-caso comparativo
Un equipo de marketing con consultas SQL frecuentes y dashboards en tiempo real puede preferir Snowflake o BigQuery por la rapidez de consulta. Un equipo de ciencia de datos que entrena modelos con grandes datasets puede inclinarse por Databricks por su soporte Spark y MLflow.
Casos prácticos y mini-casos
Los ejemplos muestran cómo ELT cambia resultados concretos.
Mini-caso 1: eCommerce que acelera análisis
Situación: retraso de 24 horas en informes de ventas. Solución ELT: cargar todas las transacciones en bruto al almacén cada hora y transformar para dashboards en ventanas de 15 minutos. Resultado: reducción del tiempo a insights de un día a minutos. Lección: separar ingestión y transformación permite iterar sin reprocesar todo.
Mini-caso 2: fintech y cumplimiento
Situación: auditorías que exigen trazabilidad. ELT aporta raw data inmutable con logs y versiones de transformaciones. Resultado: auditoría rápida y menos disputas sobre cálculos. Requisito: políticas de retención y encriptación desde la carga.
Buenas prácticas y errores comunes
Adoptar ELT sin disciplina lleva a problemas operativos. Estas prácticas reducen riesgos.
- Catalogar y etiquetar datos: cada tabla raw necesita metadatos de origen y fecha de ingestión.
- Versionar transformaciones: usar control de versiones para SQL y pipelines.
- Automatizar pruebas: validar esquemas y conteos antes y después de transformaciones.
- Control de costes: monitorizar consultas y dimensionar clústeres según demanda.
Errores comunes: dejar raw data sin gobernanza, ejecutar transformaciones pesadas sin escalado y confiar solo en permisos a nivel de cuenta en lugar de políticas por tabla.
Cómo empezar: pasos concretos para implementar ELT
El camino se recorre con pasos claros y medibles.
- Inventario de fuentes: identificar frecuencias, volúmenes y propietarios.
- Seleccionar destino: elegir warehouse o lakehouse según patrones de consulta.
- Diseñar pipelines de carga: asegurar idempotencia y tolerancia a fallos.
- Implementar transformaciones versionadas y pruebas automáticas.
- Definir gobernanza: roles, retención y encriptación.
Conclusión práctica y accionable
ELT en la nube no es solo una arquitectura técnica; es un cambio operativo que permite iterar más rápido y mantener la trazabilidad de los datos. Para avanzar sin grandes riesgos, seguir estos tres pasos iniciales:
- 1. Probar con un dominio pequeño: seleccionar una fuente y montar un pipeline ELT para medir latencia y coste reales.
- 2. Definir gobernanza mínima viable: etiquetado, roles y pruebas automáticas antes de ampliar el scope.
- 3. Automatizar y medir: métricas de ingestión, tiempo de transformación y coste por consulta para ajustar arquitectura y políticas.
Con esos pasos, la organización puede validar beneficios sin sobrecomprometer recursos. ELT en la nube funciona cuando se combina escala técnica con disciplina operativa.