Modelo relacional: cómo organizar datos y cuándo elegirlo

El modelo relacional organiza la información en tablas relacionadas mediante claves. Es una buena opción cuando los datos tienen una estructura reconocible y la aplicación necesita consultar, combinar y actualizar esa información con reglas claras. Para decidir si encaja, hay que mirar cómo se relacionan las entidades, qué cambios deben conservarse juntos y qué consultas necesita el sistema; no basta con contar tablas.
Cómo se representa una relación entre datos
Una tabla representa un tipo de entidad o una asociación: por ejemplo, clientes, pedidos o productos. Cada fila es un registro y cada columna describe uno de sus atributos. En una base de datos relacional, las tablas se conectan mediante valores comunes, no porque una fila contenga físicamente otra fila completa.
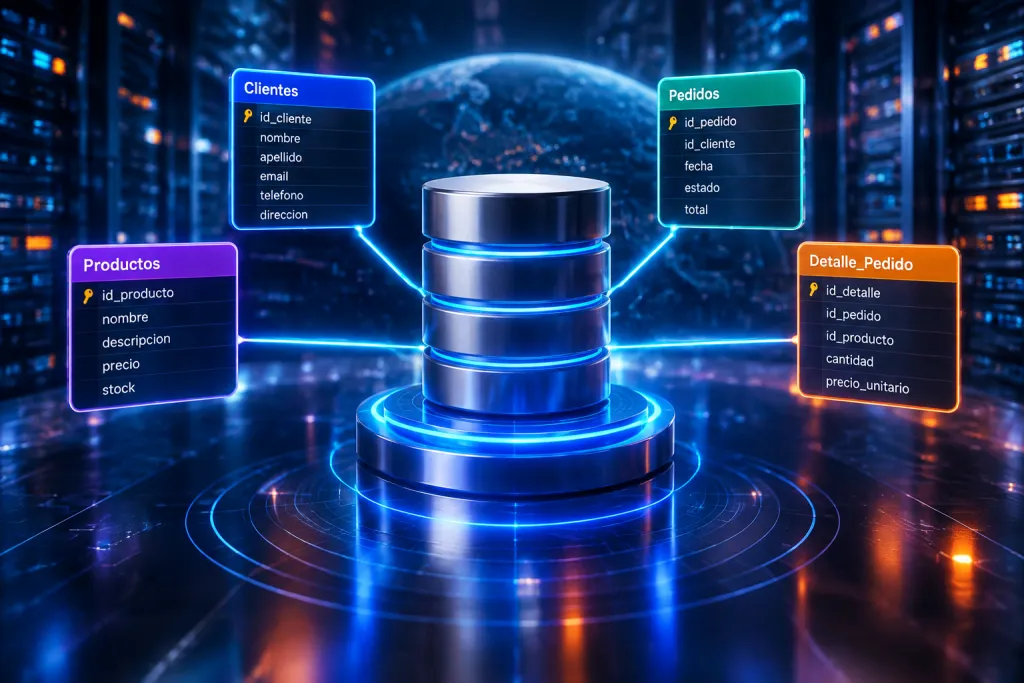
En una tabla clientes, una fila podría identificar a una persona mediante cliente_id. La tabla pedidos incluiría su propio identificador y una columna cliente_id que señala quién realizó cada pedido. Esa referencia permite consultar los pedidos de una persona sin repetir en cada uno su nombre, teléfono y dirección de contacto.
El término «relacional» alude a esta organización y a las operaciones que permiten trabajar con relaciones entre conjuntos de datos. SQL (Structured Query Language, o lenguaje de consulta estructurada) es el lenguaje habitual para consultar y modificar información en muchos sistemas relacionales, aunque cada producto puede incorporar diferencias en funciones y sintaxis.
Claves primarias y claves externas
La clave primaria identifica de forma única cada fila. Puede ser un número, un identificador generado por la aplicación u otro valor adecuado. Para que cumpla su función, no debe repetirse ni quedar vacío. Una clave primaria artificial, como pedido_id, suele ser práctica cuando los datos naturales —por ejemplo, un correo electrónico— pueden cambiar o no son únicos.
La clave externa referencia una clave de otra tabla. En el ejemplo, pedidos.cliente_id apunta a clientes.cliente_id. Una restricción de integridad referencial puede impedir que se registre un pedido para un cliente inexistente. También obliga a decidir qué debe ocurrir si se intenta borrar un cliente que todavía tiene pedidos: rechazar el borrado, conservar los pedidos con otra regla o aplicar una acción definida de forma explícita.
Un ejemplo: pedidos con varios productos
Un pedido puede incluir varios productos, y un mismo producto puede aparecer en muchos pedidos. Es una relación de muchos a muchos. Guardar una lista de productos en una columna de pedidos dificulta consultar cantidades, validar referencias y actualizar cada artículo de forma independiente. La estructura habitual separa la información en tablas:
clientes: identificador y datos del cliente.pedidos: identificador, cliente, fecha y estado.productos: identificador, descripción y otros atributos propios del producto.lineas_pedido: pedido, producto, cantidad y precio aplicado a esa línea.
La tabla lineas_pedido resuelve la relación muchos a muchos: cada fila asocia un producto con un pedido concreto. Su clave podría estar formada por pedido_id y producto_id, o ser un identificador independiente con una restricción que evite duplicados si el diseño lo requiere.
Hay una decisión importante en el precio. El precio actual del producto y el precio cobrado en un pedido no representan necesariamente lo mismo: el catálogo puede cambiar, mientras que el pedido debe conservar el importe acordado en el momento de la compra. Por eso, almacenar el precio aplicado en la línea es una decisión de modelado razonable. Es un ejemplo hipotético, pero ilustra una regla general: una tabla debe guardar los hechos que necesita conservar, no limitarse a copiar los datos que parecen relacionados.
Normalizar para reducir inconsistencias
La normalización consiste en organizar las tablas para que cada dato se almacene en el lugar apropiado y las dependencias entre atributos sean coherentes. En el ejemplo, guardar el nombre y el teléfono del cliente repetidos en todas sus líneas de pedido crea varias copias del mismo dato. Si cambia el teléfono, habría que actualizar cada repetición; si alguna queda sin modificar, la base contendría versiones contradictorias.
Separar clientes, pedidos y líneas reduce ese tipo de anomalía. También evita que borrar una línea de pedido elimine accidentalmente información del catálogo. La normalización no es un objetivo de pureza aislado: facilita mantener la coherencia y expresar las reglas del negocio.
Desnormalizar significa introducir duplicaciones controladas, por ejemplo para acelerar una consulta o simplificar una lectura frecuente. Puede ser útil, pero añade trabajo: hay que mantener sincronizados los valores duplicados y comprobar qué ocurre cuando una operación falla a mitad de camino. Antes de desnormalizar, identifica la consulta que resulta costosa y mide el problema; no presupongas que más duplicación hará que el sistema sea más rápido en conjunto.
Transacciones: cambios que deben completarse juntos
Una transacción agrupa operaciones para que se traten como una unidad según las garantías que ofrezca el sistema. Al registrar un pedido, por ejemplo, la aplicación podría crear la cabecera y sus líneas, además de actualizar otros datos relacionados. Si se guarda la cabecera pero falla la creación de las líneas, el pedido quedaría incompleto. Una transacción permite confirmar el conjunto o revertirlo cuando se produce un error, siempre que las operaciones estén dentro de su alcance y el motor y la configuración proporcionen esa garantía.
Esta propiedad resulta especialmente útil cuando una operación modifica varias tablas y el sistema no debe aceptar estados parciales. No sustituye a las copias de seguridad, a la validación de datos ni a un diseño correcto: define cómo se agrupan cambios dentro de la base, pero no evita por sí sola todos los errores de aplicación o de operación.
Cuándo encaja y cuándo explorar otra estructura
Un modelo relacional encaja bien cuando existen entidades y reglas identificables, las referencias entre ellas deben validarse y las consultas combinan datos de varias tablas. También es una elección natural para operaciones que necesitan coherencia entre varios cambios, como gestionar pedidos, facturas, inventario o registros administrativos. La estructura explícita ayuda a detectar errores de referencia y a explicar qué significa cada dato.
Si la información cambia mucho de forma entre un registro y otro, o se incorpora como documentos con atributos variables, una base de datos documental puede resultar más directa para ciertos usos. Si el problema principal son relaciones complejas entre nodos, una base de datos de grafos puede facilitar consultas específicas. Ninguna alternativa elimina la necesidad de definir qué se almacena, cómo se valida y qué consultas debe atender.
La escala, por sí sola, no decide el modelo. Antes de cambiar de tecnología, concreta el volumen y el patrón de acceso, identifica las consultas lentas y revisa índices, diseño de consultas y configuración. Un índice puede acelerar búsquedas sobre columnas seleccionadas, pero ocupa espacio y añade trabajo en inserciones y modificaciones; crear índices para cada campo no es una solución general.
Preguntas para revisar el diseño antes de implementarlo
Un esquema inicial se puede contrastar con casos concretos. Para cada tabla, define qué representa una fila y qué identifica de forma única ese registro. Después, comprueba las relaciones: si una entidad puede asociarse a varias de otra, decide si hace falta una tabla intermedia. Por último, recorre las operaciones habituales y verifica qué datos se crean, cambian o eliminan en cada una.
- ¿Se puede guardar una referencia a un registro que no existe?
- ¿Qué datos deben conservar su valor histórico aunque cambie el dato actual?
- ¿Qué pasa si una operación relacionada falla antes de terminar?
- ¿Las consultas necesarias se resuelven con las relaciones definidas o dependen de duplicaciones difíciles de mantener?
- ¿Qué cambios de estructura son previsibles y cómo se aplicarán sin perder información?
Responderlas con ejemplos de altas, cambios, consultas y borrados descubre problemas antes de que el esquema se convierta en una dependencia difícil de modificar. Para ampliar conceptos relacionados con el diseño y la gestión de datos, puedes consultar la sección de Bases de Datos.