¿Qué es almacenamiento columnar en bases de datos? Cuándo usarlo y qué esperar
¿Qué es almacenamiento columnar en bases de datos? Es una forma de organizar los datos que guarda juntos los valores de una misma columna, en lugar de almacenar consecutivamente todos los campos de cada registro. La diferencia parece interna, pero cambia el coste de las consultas: puede hacer mucho más eficiente calcular ventas por región o promedios mensuales, mientras que no necesariamente mejora la búsqueda y modificación de una sola fila.
Por eso, elegir este modelo no consiste en decidir cuál tecnología es más moderna, sino en entender qué operaciones dominarán la carga de trabajo. El almacenamiento columnar suele encajar en analítica, informes y exploración de grandes volúmenes de datos. Para una aplicación que registra pedidos y actualiza su estado continuamente, una base orientada a filas puede ser una opción más natural.
La diferencia se entiende mejor con una tabla de ventas
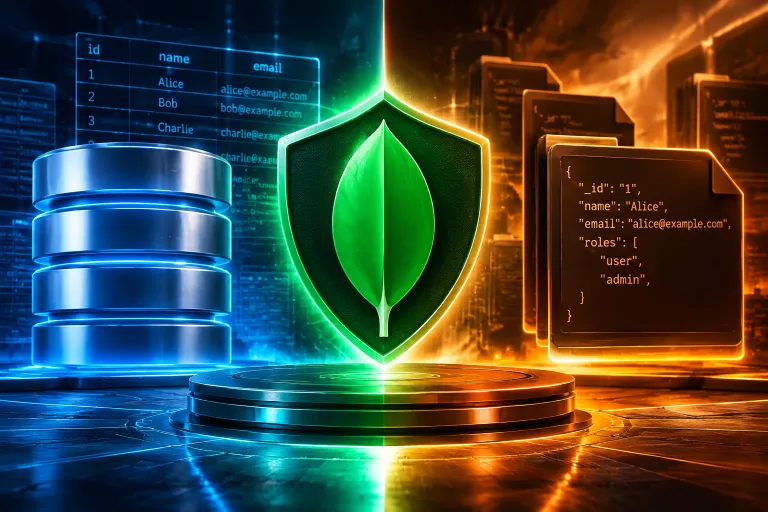
Imagina una tabla con cuatro campos: fecha, producto, región e importe. En una organización por filas, los datos podrían guardarse conceptualmente así:
2026-10-12, teclado, norte, 80
2026-10-12, monitor, sur, 240
2026-10-13, teclado, norte, 80
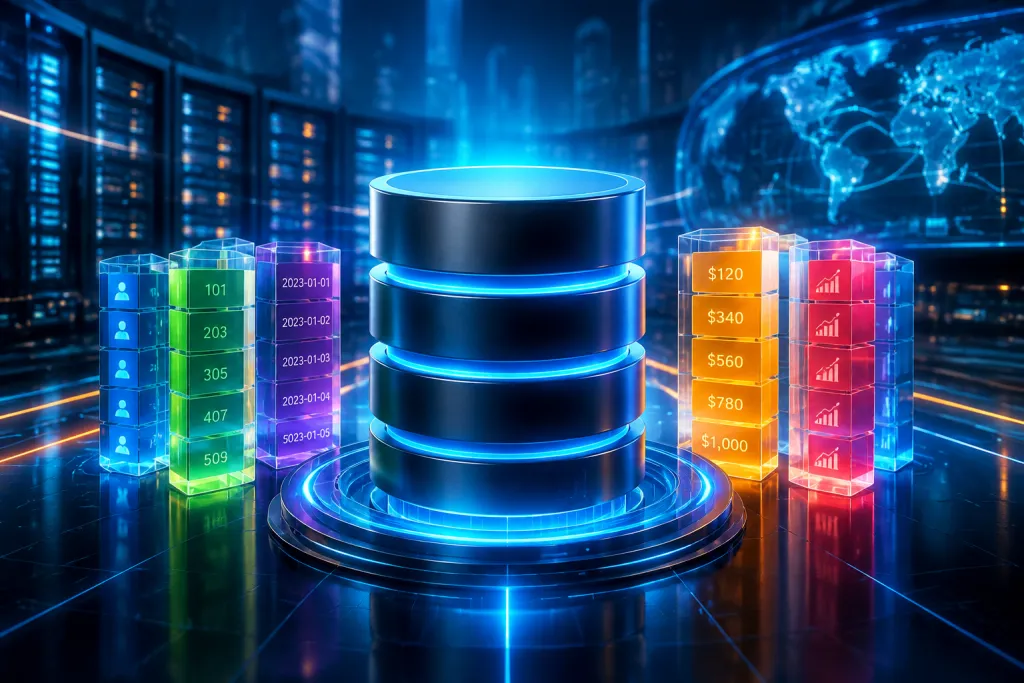
En una organización columnar, el sistema agrupa por separado los valores de cada campo: una secuencia para fechas, otra para productos, otra para regiones y otra para importes. No significa necesariamente que cada columna se guarde en un archivo independiente; es una manera de describir cómo se distribuyen y procesan los datos físicamente.
La diferencia importa cuando una consulta solicita solo dos campos. Para calcular los ingresos por región, el motor necesita principalmente las columnas de región e importe. En un formato columnar puede leer esas columnas sin recorrer todos los valores de fecha y producto. En un sistema orientado a filas, los campos suelen estar almacenados juntos, de modo que una lectura analítica amplia puede implicar mover datos que la consulta no utiliza.
El diseño no elimina el trabajo de buscar registros ni garantiza que cualquier consulta sea rápida. El rendimiento depende también de índices, particiones, formato, distribución, filtros, memoria y calidad de la consulta. La orientación de almacenamiento es una pieza del diseño, no una solución aislada.
Por qué funciona bien en analítica
Una carga analítica suele leer muchas filas y pocas columnas. Por ejemplo, un informe puede sumar el importe de millones de transacciones agrupadas por mes, aunque la tabla contenga decenas de campos. El motor columnar puede concentrarse en los datos relevantes y evitar parte de la lectura innecesaria.
Además, las columnas suelen contener valores del mismo tipo y, con frecuencia, repeticiones o patrones similares. Una columna de país puede repetir unas pocas categorías millones de veces; una de estado de pedido tendrá una variedad limitada de valores. Esa regularidad permite aplicar compresión con eficacia. Menos bytes almacenados pueden significar menos espacio en disco y menos datos que mover desde el almacenamiento a la memoria durante una consulta.
También es común que los motores analíticos procesen los valores por bloques y realicen operaciones vectorizadas. En lugar de tratar cada registro como una unidad aislada, aplican una operación a grupos de valores de una columna. Esto aprovecha mejor las capacidades de los procesadores en tareas como sumar, filtrar o comparar grandes conjuntos.
Considera una empresa que recibe 30 millones de eventos al mes y necesita responder preguntas como «¿qué canal generó más ingresos en cada zona?» o «¿cómo cambió la conversión semana a semana?». Si los análisis consultan con frecuencia unas pocas columnas y agregan grandes cantidades de registros, el formato columnar puede reducir las lecturas y el tiempo de procesamiento. El beneficio debe comprobarse con datos y consultas representativos: no se deduce solo del número de filas.
Cuándo conviene y cuándo puede ser una mala elección
El almacenamiento columnar suele ser apropiado para almacenes de datos, plataformas de inteligencia de negocio, análisis de eventos, cuadros de mando y consultas históricas. También resulta útil cuando se conservan grandes volúmenes y se ejecutan agregaciones repetidas sobre subconjuntos de campos. En estos escenarios, importa más leer con eficiencia una parte de muchas filas que modificar un registro individual con frecuencia.
En cambio, una aplicación transaccional suele buscar, insertar o actualizar registros completos: crear una cuenta, cambiar la dirección de un cliente, registrar un pago o avanzar un pedido de estado. Estas operaciones suelen beneficiarse de una organización por filas, porque los campos de una entidad están disponibles juntos y las modificaciones puntuales son una parte central del trabajo.
Un almacenamiento columnar puede admitir escrituras, pero no conviene asumir que tendrá el mismo comportamiento que una base OLTP diseñada para transacciones frecuentes y pequeñas. Algunos sistemas agrupan escrituras en lotes o mantienen datos recientes en estructuras distintas antes de reorganizarlos. Esa arquitectura puede ser perfectamente válida para una plataforma analítica, aunque añade consideraciones sobre latencia, consistencia y mantenimiento.
La distinción tampoco obliga a escoger una sola tecnología para toda la organización. Es habitual que una aplicación transaccional mantenga su base principal orientada a filas y replique o transforme los datos hacia un almacén columnar para los informes. Así se evita que los análisis pesados compitan directamente con las operaciones que mantienen la aplicación en servicio.
Qué revisar antes de elegir una solución
Antes de comparar productos, conviene describir la carga real. Una decisión basada en etiquetas como «rápido» o «escalable» suele ocultar las diferencias que afectan al coste y al rendimiento. Estas preguntas ayudan a acotar el diseño:
- ¿Qué consultas se ejecutan? Anota los filtros, agrupaciones, columnas seleccionadas y frecuencia. No es lo mismo buscar un pedido por identificador que sumar importes por trimestre.
- ¿Cuántos datos se leen? Distingue entre el tamaño total de la tabla y la parte que examina cada consulta. Una tabla grande con filtros selectivos puede comportarse de forma distinta a un análisis que recorre años de historia.
- ¿Cómo llegan los datos? Considera si se insertan de forma continua, por lotes o mediante cargas periódicas, y cuánta demora entre el evento y el informe es aceptable.
- ¿Qué modificaciones hacen falta? Registra si hay actualizaciones frecuentes de filas existentes, eliminaciones, correcciones retroactivas o principalmente inserciones.
- ¿Cuál es el coste completo? Incluye almacenamiento, computación, copias, transferencia de datos, mantenimiento y tiempo de operación. Una consulta rápida puede requerir más capacidad si la configuración no aprovecha bien los recursos.
Una prueba útil utiliza una muestra con distribución y volumen parecidos a los reales, junto con consultas de producción representativas. Si la muestra tiene pocos datos o no refleja valores repetidos, filtros habituales y tamaños de lote, el resultado puede llevar a una decisión equivocada. Mide latencia, consumo de recursos, coste y estabilidad cuando varias consultas se ejecutan al mismo tiempo.
Compresión, particiones y formatos: decisiones que cambian el resultado
La compresión es uno de los motivos por los que el almacenamiento columnar puede ser eficiente, pero no todas las columnas se comprimen igual. Categorías repetidas y secuencias ordenadas suelen ofrecer oportunidades mayores que identificadores aleatorios. Si cada valor es único y poco predecible, el ahorro puede ser menor. La tasa real debe medirse con los datos propios, no suponerse a partir de una promesa general.
Ordenar o agrupar datos por campos de uso frecuente también puede ayudar a descartar bloques que no contienen los valores buscados. Por ejemplo, organizar los registros por fecha puede favorecer consultas que limitan el análisis a un periodo. Pero una disposición óptima para un filtro puede ser menos conveniente para otro. No suele ser posible ordenar físicamente los datos de manera perfecta para todas las preguntas.
Las particiones separan conjuntos de datos según un criterio, a menudo una fecha o una región. Una consulta que pide solo un mes puede evitar leer particiones de otros periodos. Sin embargo, crear particiones demasiado pequeñas aumenta la complejidad y puede generar muchos archivos de poco tamaño; particionar por demasiados campos también dificulta la gestión. La estrategia debe corresponder a filtros comunes y al modo de carga, no a cada posible pregunta futura.
En lagos de datos aparecen formatos columnares como Parquet y ORC. Estos formatos describen cómo serializar datos para facilitar lectura por columnas, compresión y procesamiento distribuido. No son por sí solos un motor de base de datos: el rendimiento depende además de la herramienta que consulta los archivos, los metadatos, el tamaño de los fragmentos y la organización del conjunto de datos.
Errores frecuentes al interpretar el rendimiento
Un error habitual es migrar una base operativa completa a un sistema analítico porque una consulta puntual tarda demasiado. Antes conviene identificar si el problema está en un filtro poco selectivo, una consulta que trae columnas innecesarias, una falta de particionamiento o la competencia por recursos. Cambiar el modelo de almacenamiento sin diagnosticar la causa puede añadir complejidad y dejar intacto el cuello de botella.
Otro fallo consiste en seleccionar todos los campos con una consulta amplia aunque el informe use solo unos pocos. En un sistema columnar, pedir columnas que no hacen falta reduce parte de la ventaja. También perjudican las funciones aplicadas sobre campos filtrados cuando impiden aprovechar índices, estadísticas o eliminación de bloques, aunque el efecto concreto depende del motor.
Por último, hay que tener en cuenta las cargas pequeñas y dispersas. Si cada proceso crea miles de fragmentos diminutos, la sobrecarga de metadatos y la planificación puede dominar el tiempo de lectura. Agrupar escrituras y compactar archivos cuando la plataforma lo requiera puede mejorar el comportamiento, pero añade tareas operativas que deben formar parte del diseño.
Una decisión práctica para el equipo de datos
¿Qué es almacenamiento columnar en bases de datos? Es una organización pensada para acceder con eficiencia a columnas seleccionadas, comprimir datos similares y procesar grandes volúmenes en consultas analíticas. Su utilidad aparece cuando coincide con la forma de trabajar de los usuarios: escaneos amplios, agregaciones e informes sobre conjuntos históricos.
Para decidir, empieza por clasificar las operaciones en transaccionales y analíticas. Si predominan cambios puntuales de registros y respuestas inmediatas para una aplicación, una base orientada a filas probablemente encaje mejor. Si predominan lecturas de muchas filas, pocas columnas y cálculos agregados, evalúa una solución columnar con una prueba que reproduzca la carga real. Cuando ambas necesidades son importantes, separarlas mediante una arquitectura transaccional y otra analítica suele ser más sensato que forzar un único sistema a resolverlo todo.
La mejor elección no es la que presume de procesar más datos, sino la que responde a las consultas necesarias con un coste y una complejidad aceptables. Medir antes de migrar, revisar el patrón de escritura y diseñar particiones con criterio son pasos concretos para aprovechar el almacenamiento columnar sin convertirlo en una solución universal.