Bases de datos en ciencias de la salud: cómo diseñarlas para investigar con datos fiables

Una base de datos para ciencias de la salud debe permitir responder una pregunta de investigación sin perder de vista de dónde procede cada dato, qué significa y quién está autorizado a consultarlo. No basta con reunir resultados clínicos en una hoja de cálculo: el diseño condiciona la calidad del análisis, la posibilidad de combinar información y la protección de las personas participantes.
Para verlo en la práctica, imaginemos un estudio hipotético que quiere evaluar si un programa de seguimiento mejora el control de la presión arterial. El equipo registra visitas, mediciones y tratamientos durante varios meses. La estructura adecuada no consiste en crear una columna distinta para cada visita, sino en separar las entidades del estudio y definir cómo se relacionan.
Del protocolo de investigación a las variables registradas
El punto de partida es el protocolo: población, criterios de inclusión, calendario de seguimiento, resultados que se medirán y forma de analizarlos. Cada variable de la base de datos debe corresponder a una necesidad concreta de ese plan. Si se recopilan datos “por si acaso”, aumenta la carga de trabajo y se acumula información que quizá no aporte valor.
En el ejemplo, el equipo podría necesitar un identificador de participante, la fecha de cada visita, la presión arterial sistólica y diastólica, el tratamiento declarado y si la visita se completó. Antes de cargar datos, debe acordar cuestiones aparentemente pequeñas: en qué unidad se expresan las mediciones, qué formato se usa para las fechas y cómo se registra una medición ausente.
Un diccionario de datos evita interpretaciones distintas
El diccionario describe cada campo: nombre, significado, tipo de dato, unidad, valores permitidos y reglas de cumplimentación. Así, “presión sistólica” no queda como una etiqueta ambigua: se especifica que representa una medición concreta, en una unidad determinada y asociada a una visita.
También se define la diferencia entre un valor desconocido, una prueba no realizada y un dato que no corresponde. Guardar todos esos casos como cero alteraría el análisis: cero sería un valor numérico, mientras que los otros estados explican por qué no existe una medición utilizable. Los códigos deben estar documentados y aplicarse de forma uniforme.
Cómo organizar participantes, visitas y mediciones
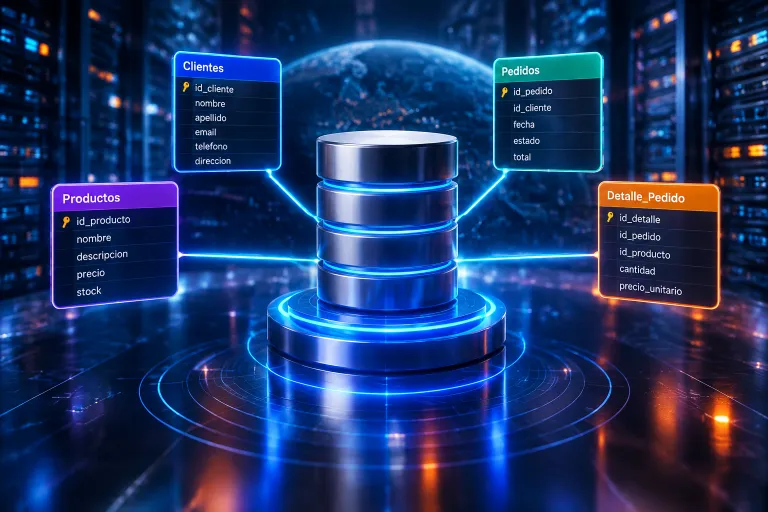
Una estructura relacional permite separar información que tiene distinta frecuencia. Una tabla de participantes puede guardar el identificador del estudio y las características recogidas una sola vez; otra tabla, las visitas; y una tercera, las mediciones. El identificador del participante enlaza sus visitas, y el de cada visita relaciona las mediciones con el momento en que se obtuvieron.
Esta separación evita repetir los datos de una persona en cada fila y facilita incorporar nuevas visitas sin modificar el diseño. Además, las claves y restricciones ayudan a detectar errores: una visita no debería quedar asociada a un participante inexistente, y una misma medición no debería duplicarse accidentalmente para la misma combinación de participante, visita y variable.
| Elemento | Qué representa | Ejemplo hipotético |
|---|---|---|
| Participante | Una persona incluida en el estudio | ID de estudio P-104 |
| Visita | Un contacto realizado en una fecha | Seguimiento del mes 3 |
| Medición | Un resultado asociado a una visita | Presión sistólica: valor y unidad |
La tabla es solo un esquema conceptual. En un sistema real, el diseño debe adaptarse al protocolo y a las necesidades de consulta, auditoría y análisis. Para comparar enfoques de almacenamiento y modelado, se pueden consultar contenidos sobre Bases de Datos.
Calidad: controles desde la entrada hasta el análisis
La validación funciona mejor cerca del momento en que se introduce el dato. Si una presión arterial debe ser numérica, el formulario puede rechazar texto no válido; si una visita requiere fecha, puede impedir guardar el registro sin ella. Los rangos plausibles sirven para señalar valores que merecen revisión, pero no deberían borrar automáticamente resultados extremos: un valor inusual puede ser un error de transcripción o un hallazgo real.
Por eso, los controles automáticos deben generar avisos revisables y conservar un rastro de las correcciones. Si alguien cambia una fecha o modifica una medición, el sistema debería permitir saber qué cambió, cuándo y por qué, según el diseño y las responsabilidades del estudio. La corrección no debe consistir en sobrescribir sin registro una observación previa.
Revisiones útiles antes de cerrar el conjunto de datos
- Buscar participantes duplicados y visitas sin participante asociado.
- Comprobar que las fechas respetan el calendario definido en el protocolo.
- Revisar valores ausentes y distinguir sus causas cuando el estudio las registra.
- Verificar unidades, rangos y coherencia entre variables relacionadas.
- Documentar cambios y resolver discrepancias con criterios acordados.
Un conjunto de datos puede estar completo y seguir siendo poco fiable si cada centro interpreta de forma distinta una variable o usa unidades diferentes. En estudios con varios equipos, el manual de procedimientos y la formación de quienes introducen datos son parte del control de calidad, no tareas separadas del trabajo técnico.
Privacidad y acceso: separar identidad y datos de investigación
Los datos de salud requieren especial cuidado porque pueden revelar información sensible. Una medida de diseño es conservar los identificadores directos —por ejemplo, nombre o datos de contacto— separados de las tablas de análisis, y utilizar un código de estudio para enlazar los registros cuando sea necesario. La tabla que relaciona el código con la identidad debe tener acceso restringido y una finalidad definida.
La seudonimización no equivale a anonimización: si existe una clave que permite volver a vincular los datos con una persona, la información sigue siendo reidentificable por quienes puedan acceder a esa clave. También hay que considerar combinaciones de variables que, aun sin nombres, podrían facilitar la identificación en determinados contextos. La minimización de datos, los permisos por función y el registro de accesos ayudan a reducir exposición.
El equipo debe establecer quién puede consultar, modificar o exportar cada conjunto de datos y cómo se gestionan las copias de seguridad y la conservación. Los requisitos legales y éticos dependen del estudio, de las instituciones implicadas y del uso previsto; por eso, el diseño técnico debe coordinarse con las personas responsables de protección de datos y con los procedimientos aplicables, en lugar de asumir que quitar los nombres resuelve todas las obligaciones.
Elegir herramientas según el uso previsto
Una hoja de cálculo puede servir para una tabla pequeña y controlada, pero se vuelve frágil cuando varias personas editan a la vez, hay múltiples visitas o se necesitan permisos diferenciados y trazabilidad. Una base de datos relacional ofrece estructura y reglas de integridad; una plataforma de captura electrónica puede añadir formularios, validaciones y gestión de usuarios. Ninguna herramienta garantiza por sí sola que el protocolo esté bien traducido ni que los datos sean correctos.
La decisión debe considerar volumen y complejidad de los registros, número de centros, necesidad de auditoría, integración con otros sistemas, capacidades del equipo y procedimientos de respaldo. Si el proyecto va a combinar fuentes o producir análisis a gran escala, el componente de gestión de datos puede conectarse con flujos de Big Data, pero eso no elimina la necesidad de definir variables y controlar su procedencia.
En el estudio hipotético, el recorrido completo sería: convertir el protocolo en un diccionario de datos; diseñar tablas de participantes, visitas y mediciones; probar formularios con registros ficticios; revisar reglas y permisos; y validar el conjunto antes del análisis. El resultado no es solo una colección de valores, sino una estructura documentada que permite interpretar cada observación y detectar qué límites tiene.