Programas de bases de datos: cómo elegir el adecuado

El programa adecuado para gestionar una base de datos depende, sobre todo, de cómo se relacionan los datos, qué consultas necesita la aplicación y quién se ocupará de mantener el sistema. Para una gestión empresarial con registros relacionados y operaciones que deben conservar su coherencia, una base de datos relacional suele ser un punto de partida sólido. Si la aplicación maneja documentos con estructuras variables o necesita repartir datos entre muchos nodos, otras tecnologías pueden encajar mejor.
Antes de comparar marcas, hay que separar dos conceptos: la base de datos es la información organizada; el sistema gestor de bases de datos (SGBD) es el software que permite almacenarla, consultarla, protegerla y administrarla. PostgreSQL, MySQL, Microsoft SQL Server y MongoDB son ejemplos de SGBD, pero no resuelven exactamente los mismos problemas ni se gestionan de la misma manera.
Empieza por las relaciones entre los datos
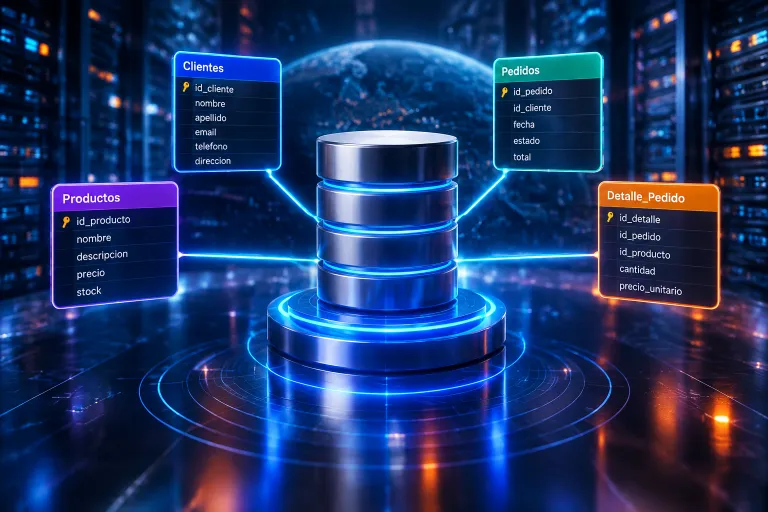
La forma de los datos determina qué modelo resulta natural. Si una aplicación registra clientes, pedidos y líneas de pedido, cada grupo tiene atributos propios y existen relaciones entre ellos. En cambio, un catálogo de contenidos con campos que varían según el tipo de elemento puede representarse de forma más flexible como documentos.
Cuándo encaja una base de datos relacional
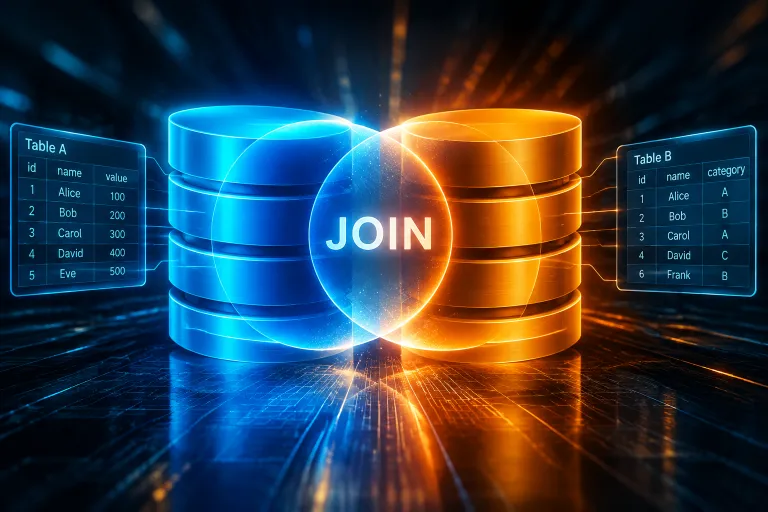
Los sistemas relacionales organizan la información en tablas y permiten expresar relaciones mediante claves. Se consultan habitualmente con SQL, el lenguaje de consulta estructurada. Son apropiados cuando importa conservar reglas como que cada pedido pertenezca a un cliente existente o que una operación actualice varios registros sin dejar el sistema a medias.
Las transacciones agrupan operaciones que deben completarse como una unidad. Por ejemplo, al registrar un pago, una aplicación hipotética podría guardar el movimiento y actualizar el estado de la factura en una misma transacción. Si una parte falla, el gestor puede deshacer los cambios de esa operación. Este comportamiento reduce inconsistencias en procesos con varias escrituras relacionadas.
PostgreSQL y MySQL son opciones relacionales habituales en aplicaciones y servicios web. Microsoft SQL Server aparece con frecuencia en entornos que ya utilizan tecnologías de Microsoft. La elección entre ellos no debería basarse solo en popularidad: también pesan las herramientas que conoce el equipo, la plataforma de despliegue, las extensiones necesarias y el modo de licenciamiento aplicable.
Cuándo valorar documentos u otros modelos
Una base documental, como MongoDB, guarda registros como documentos, normalmente con campos que pueden diferir entre unos registros y otros. Puede resultar útil si los datos se consultan principalmente como unidades completas y su estructura cambia con frecuencia. Esa flexibilidad no elimina la necesidad de diseñar: si se repiten datos en varios documentos, habrá que decidir cómo actualizarlos y evitar divergencias.
También existen bases de datos clave-valor, de grafos, de series temporales y otros modelos especializados. Una base clave-valor puede servir para buscar rápidamente un elemento mediante una clave; una de grafos representa entidades y sus conexiones; una de series temporales está pensada para datos asociados a momentos, como mediciones de sensores. No son sustitutos universales de una base relacional: tienen sentido cuando su modelo se ajusta a las consultas principales.
Compara opciones con consultas reales
Una lista de funciones comerciales dice poco si no se relaciona con el trabajo que hará la aplicación. Anota las operaciones esenciales y comprueba cómo las resolvería cada candidato. Por ejemplo, para un sistema de reservas habría que consultar disponibilidad por fecha, evitar asignar dos veces el mismo recurso y recuperar el historial de una reserva. La pregunta práctica es si el gestor permite expresar esas reglas de forma clara y mantenerlas bajo carga.
- Coherencia: identifica qué reglas deben cumplirse siempre, como la unicidad de un identificador o la existencia de una relación entre registros.
- Consultas: describe filtros, ordenaciones, agregaciones y relaciones que la aplicación ejecutará con frecuencia.
- Volumen y crecimiento: estima el tamaño y el ritmo de escritura con datos propios o una previsión razonada; evita elegir por una cifra teórica aislada.
- Concurrencia: determina cuántos procesos o usuarios pueden leer y modificar información al mismo tiempo.
- Integración: revisa la compatibilidad con el lenguaje de programación, las herramientas de análisis y las aplicaciones existentes.
Si dos alternativas parecen válidas, prepara una prueba pequeña con datos representativos y las consultas más importantes. Mide cuánto tardan, observa qué índices requieren y comprueba qué ocurre cuando varias operaciones se ejecutan a la vez. Una prueba así no sustituye a una evaluación de producción, pero permite detectar pronto una estructura incómoda o una consulta difícil de mantener.
Local, en la nube o gestionada: quién opera el sistema
El modelo de despliegue cambia las tareas del equipo, no solo el lugar donde se guardan los datos. Con una instalación propia, la empresa controla el entorno y asume la configuración del servidor, las actualizaciones, la supervisión y la recuperación. En un servicio gestionado, el proveedor se ocupa de parte de la infraestructura, aunque siguen siendo responsabilidad del cliente decisiones como los permisos, la estructura de datos y la estrategia de recuperación adecuada.
Una alternativa gestionada puede reducir trabajo operativo, pero hay que comprobar qué tareas incluye realmente el servicio y qué queda fuera. También interesa revisar cómo se exportan los datos, qué opciones hay para restaurar una copia y qué dependencia se crea respecto a herramientas específicas. En una instalación propia, el coste de licencia no representa por sí solo el coste total: administración, copias, supervisión y capacidad del equipo también requieren recursos.
Para una aplicación pequeña en un único servidor, una base relacional bien configurada puede ser suficiente. Añadir desde el principio varios componentes especializados aumenta la carga de operación. A la inversa, si una organización necesita distribuir cargas entre regiones o separar tipos de consulta, puede tener razones concretas para adoptar varios sistemas. Esa arquitectura debe justificarse por requisitos medibles y no por la expectativa de que una tecnología más compleja será automáticamente más rápida.
Seguridad, copias y recuperación forman parte de la elección
Un programa de base de datos no protege por sí solo toda la información. La configuración debe limitar los permisos: una cuenta de aplicación que solo necesita leer y escribir ciertos datos no debería tener privilegios de administración. También hay que proteger las conexiones, gestionar credenciales y registrar la actividad relevante conforme a las necesidades del sistema.
Las copias de seguridad solo son útiles si se pueden recuperar. Define qué pérdida de información sería aceptable y cuánto tiempo podría permanecer interrumpido el servicio; esos objetivos orientan la frecuencia de las copias y el procedimiento de restauración. Después, realiza pruebas de recuperación en un entorno controlado. Una copia que nunca se ha restaurado no demuestra por sí sola que el servicio pueda volver a funcionar.
La actualización también requiere planificación. Antes de cambiar de versión o de plataforma, comprueba la compatibilidad de la aplicación, las extensiones y los controladores que utiliza. En sistemas importantes, prepara una ruta de vuelta y prueba el cambio con una copia representativa. El nivel de control disponible varía entre una instalación propia y un servicio gestionado, así que el plan debe corresponder al modelo elegido.
Una decisión práctica para una empresa
Supongamos una aplicación hipotética que registra clientes, facturas y pagos. Si necesita impedir referencias a clientes inexistentes y asegurar que cada pago se asocia a una factura válida, un SGBD relacional es un candidato natural. La empresa podría comparar PostgreSQL, MySQL o SQL Server según sus integraciones, conocimientos internos, despliegue y soporte disponible. Si, además, maneja documentos de contenido con campos muy distintos y pocas relaciones entre ellos, podría mantenerlos en el sistema principal o valorar un almacén documental para esa necesidad concreta.
La decisión no exige que todos los datos vivan en un único producto, pero cada sistema adicional implica sincronización, supervisión y más puntos de fallo. Por eso, lo habitual es empezar con el modelo más sencillo que cumpla los requisitos y añadir otra tecnología cuando una necesidad concreta lo justifique. Para profundizar en conceptos y herramientas relacionados, se pueden consultar los contenidos de bases de datos.