Tabla en una base de datos: cómo diseñarla y cuándo dividirla

Una tabla en una base de datos organiza información de un mismo tipo en columnas (los datos que se guardan de cada elemento) y filas (cada elemento registrado). Para diseñarla bien, define qué representa cada fila, elige tipos de datos adecuados y establece reglas que impidan guardar valores inválidos o duplicados.
Por ejemplo, una aplicación de inventario podría tener una tabla de productos. Cada fila correspondería a un producto; sus columnas, a propiedades como el nombre, el precio y la cantidad disponible. Esta estructura no es solo una manera de presentar datos: también determina qué consultas se pueden hacer con fiabilidad y cómo se relaciona esa información con el resto de la aplicación.
Empieza por definir qué representa cada fila
Antes de escoger nombres de columnas, escribe una frase que describa una fila: «una fila representa un producto del catálogo» o «una fila representa una línea de un pedido». Si la frase no está clara, quizá la tabla mezcla entidades distintas o no se ha definido bien el nivel de detalle.
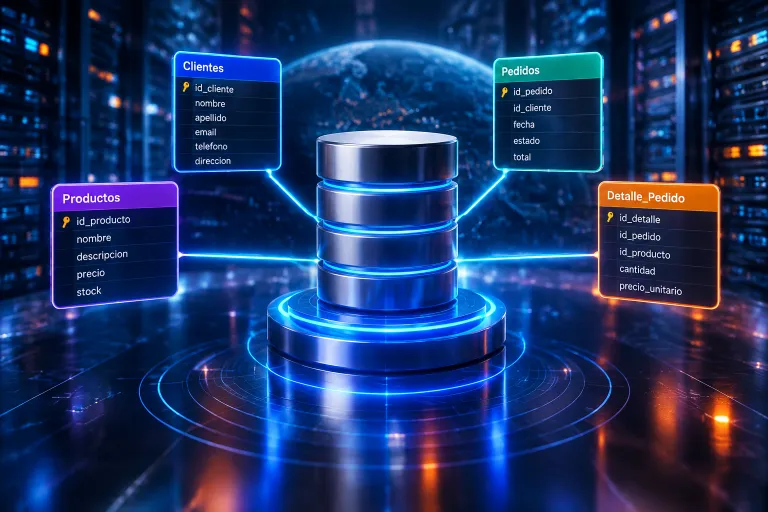
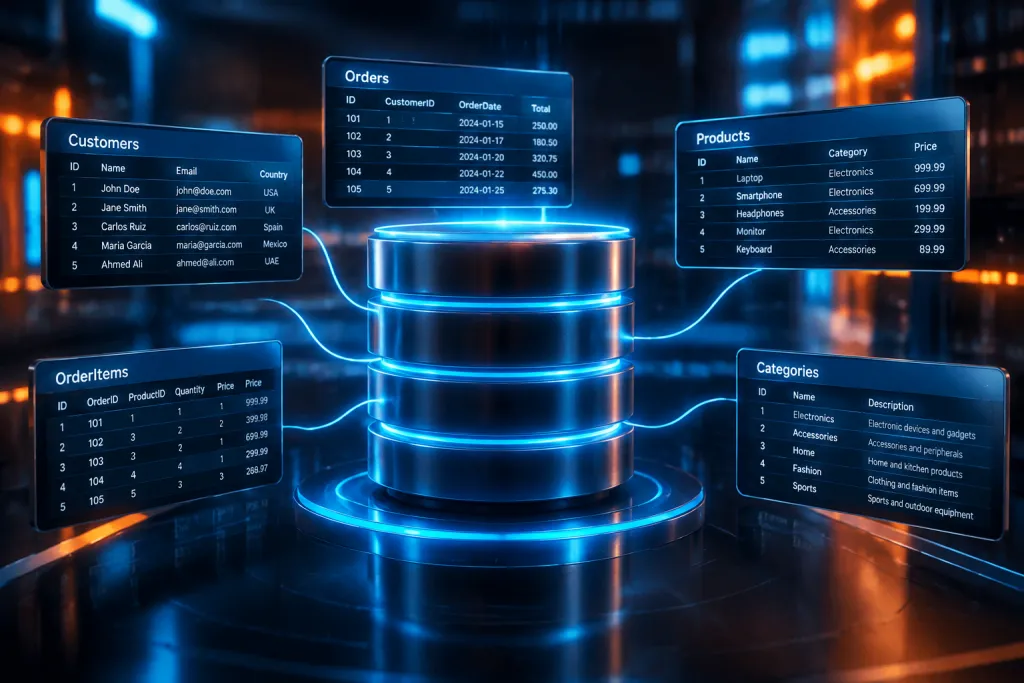
La diferencia es importante en un pedido. Una fila por pedido puede incluir su fecha y su cliente, pero no describe de forma ordenada todos los productos que contiene. Si se guardan varios productos en una misma celda, por ejemplo «teclado, ratón, monitor», resulta difícil buscar uno de ellos, contar unidades o aplicar un precio distinto a cada artículo. Una solución habitual es separar pedidos y líneas de pedido: cada línea identifica un producto, una cantidad y su precio en ese pedido.
Evita columnas que cambian de significado
Una columna debe describir siempre el mismo atributo. Guardar en un campo llamado contacto a veces un correo electrónico y otras veces un número de teléfono obliga a interpretar el contenido fila por fila. Es más sencillo validar y consultar la información si cada dato tiene su propia columna, como email y telefono.
También es preferible no crear columnas repetidas como producto_1, producto_2 y producto_3 para representar una lista de elementos. Además de imponer un límite arbitrario, esta forma dificulta las consultas y los cambios posteriores. Cuando una entidad puede tener varios elementos asociados, normalmente hace falta otra tabla relacionada.
Elige tipos de datos según el uso real
El tipo de una columna indica qué clase de valor acepta la base de datos. Un identificador puede almacenarse como número o como texto, según cómo se genere y utilice; un precio debe tener una representación numérica apropiada para importes, no un campo de texto libre; una fecha debe guardarse como fecha y no como una cadena cuyo formato pueda variar.
Por ejemplo, un código de producto como 000427 puede necesitar conservar los ceros iniciales y no utilizarse en operaciones aritméticas. En ese caso, tratarlo como texto suele reflejar mejor su función que guardarlo como número. En cambio, una cantidad disponible sí puede necesitar cálculos. La decisión depende del significado del dato, no de su aspecto en una pantalla.
- Texto: nombres, códigos alfanuméricos o descripciones, con una longitud adecuada a lo que se espera almacenar.
- Números: cantidades o valores sobre los que se realizarán operaciones. Para importes, comprueba cómo representa decimales el sistema de base de datos.
- Fecha y hora: momentos que deban ordenarse, compararse o filtrarse temporalmente.
- Valores booleanos: estados con dos opciones, como si un producto está activo, cuando ese significado sea suficiente para la aplicación.
Los detalles de los tipos y su sintaxis varían entre sistemas como PostgreSQL, MySQL y SQL Server. Antes de ejecutar una definición, verifica la documentación de la base de datos concreta y considera cómo se migrará o consultará el dato.
Usa claves y restricciones para proteger la calidad de los datos
Una clave primaria identifica de forma única cada fila. En la tabla de productos podría ser un identificador interno, como producto_id, en vez del nombre: dos productos pueden llamarse igual y un nombre puede cambiar. Una clave primaria no debe repetirse y no puede quedar sin valor.
Cuando una tabla necesita referirse a otra, una clave foránea guarda el identificador de la fila relacionada y permite comprobar que esa referencia existe. En un modelo sencillo, cada línea de pedido podría guardar un pedido_id y un producto_id. Así se evita que una línea apunte a un pedido o producto inexistente, siempre que la relación esté definida correctamente en la base de datos.
Las restricciones adicionales expresan reglas del negocio que se deben cumplir al insertar o modificar datos. Por ejemplo, una restricción puede impedir que la cantidad de un producto sea negativa; otra, exigir que un correo de usuario no se repita. Las restricciones exactas disponibles y su comportamiento dependen del motor, pero aplicar las reglas en la propia base de datos añade una defensa frente a errores de distintas partes de una aplicación.
Decide qué campos admiten ausencia
Permitir un valor nulo significa admitir que el dato no esté disponible, no que sea igual a cero o a una cadena vacía. Para una dirección secundaria puede ser válido dejar el campo sin valor. Para una fecha obligatoria de creación, en cambio, una ausencia podría hacer que los registros pierdan sentido. Define esta regla campo por campo y distingue entre «desconocido», «no aplicable» y «ninguno», si el proceso necesita diferenciarlos.
Cuándo separar una tabla en varias
Si un dato se repite muchas veces y describe una entidad independiente, separarlo suele reducir inconsistencias. En un catálogo con proveedores, por ejemplo, guardar el nombre y la dirección completos del proveedor en cada producto repite información. Si la dirección cambia, habría que actualizar todas las filas afectadas y alguna podría quedar desactualizada. Una tabla de proveedores permite mantener esos datos una vez y relacionarlos con los productos.
Separar tablas no consiste en fragmentar cada campo por sistema. El criterio práctico es identificar dependencias: si una propiedad pertenece al proveedor y no al producto, debería organizarse en torno al proveedor; si describe la relación concreta entre un pedido y un producto —por ejemplo, las unidades pedidas— pertenece a la línea de pedido.
Este proceso de organizar los datos para reducir duplicidades y anomalías se conoce como normalización. No elimina toda repetición ni obliga a crear un modelo complejo; ayuda a que cada hecho tenga un lugar coherente. Las necesidades de análisis o rendimiento pueden justificar después estructuras adicionales, pero primero conviene asegurar que el modelo representa correctamente la información de origen. Para ampliar conceptos relacionados, consulta la sección de bases de datos.
Un ejemplo de definición y sus comprobaciones
Este ejemplo hipotético ilustra una tabla de productos con identificador, nombre, precio y estado. La sintaxis es similar a la de varios sistemas SQL, aunque puede requerir ajustes según el motor utilizado:
CREATE TABLE productos (
  producto_id INTEGER PRIMARY KEY,
  nombre VARCHAR(150) NOT NULL,
  precio DECIMAL(10, 2) NOT NULL,
  activo BOOLEAN NOT NULL,
  CHECK (precio >= 0)
);
El identificador distingue las filas; el nombre y el precio son obligatorios; el precio no puede ser negativo. La forma de generar automáticamente el identificador, así como el tipo booleano y algunas opciones de restricciones, varía entre bases de datos. No copies la sentencia sin comprobarla en el entorno de destino.
Antes de poner en uso una tabla, revisa estas cuestiones:
- Significado: ¿puedes explicar en una frase qué representa cada fila?
- Identificación: ¿hay una clave que distinga cada fila incluso si otros datos cambian?
- Tipos y valores: ¿los campos permiten los cálculos y formatos necesarios y rechazan lo que no tiene sentido?
- Relaciones: ¿las referencias entre tablas impiden asociar registros inexistentes?
- Consultas previstas: ¿qué datos se buscarán, filtrarán o mostrarán juntos y con qué frecuencia?
Índices: aceleración con un coste
Un índice ayuda a localizar filas por determinados valores sin revisar necesariamente toda la tabla. Puede ser útil, por ejemplo, para buscar productos por un código único o filtrar pedidos por cliente. No sustituye a una clave primaria ni corrige un modelo confuso: su función es mejorar ciertas consultas.
Crear índices indiscriminadamente también tiene costes. Cada índice ocupa espacio y la base de datos debe mantenerlo cuando se insertan, eliminan o modifican filas. Por eso, el índice adecuado se decide observando las consultas reales y, cuando la aplicación ya está en marcha, las herramientas de análisis del motor. Añadir uno por cada columna no garantiza que las búsquedas sean más rápidas.
Una tabla útil combina una representación clara de la información con reglas que protegen su coherencia. Cuando está definido qué significa cada fila, qué valores son válidos y cómo se relacionan las entidades, resulta más sencillo consultar los datos y adaptar la aplicación sin depender de interpretaciones implícitas.